Polars 2.0 は 2026 年 10 月 6 日にリリースされた、Python の DataFrame ライブラリ Polars のメジャーバージョン です1 collect() が既定でストリーミングエンジンを使うようになったことです。暗黙の型変換や長さ違いの結合もエラーになりました。速くなる代わりに、join や group_by の結果の行の順序が保証されなくなります。この記事では、2026 年 10 月 9 日に筆者が手元の venv で Polars 1.44.2・Polars 2.0.0・pandas 3.0.6 を動かした結果をもとに、2.0 の変更点、pandas からの書き換え対応表、Lazy API の使い方、1,000 万行での実測、Claude Code に移行を手伝わせるときのコツをまとめます。
Polars 2.0 は、新機能よりも「既定値」と「厳格さ」を変えたリリース です。開発元は 2.0 の狙いを「過去の設計判断を捨て、多くの人に合う既定値に変えること」と説明しています2 1 3
変更 内容 影響 ストリーミングエンジンが既定 LazyFrame.collect() の engine="auto" がストリーミングエンジンになる速く・省メモリになる。join・group_by・unpivot の行の順序は保証されない アウトオブコア(ディスク退避)が既定で有効 RAM の約 80% を超えると sort やウィンドウ関数がディスクに退避する。既定の上限は 64GB4 メモリに載らないデータでも止まりにくい SQL を一級市民に 最適化(join の並べ替え、共通部分計画の除去、動的述語・ブルームフィルタ)を SQL にも適用 pl.sql() も同じエンジンで速くなるMap 型の追加 Arrow の MapType を pl.Map として扱う。map.get() などの式がある 辞書のような列を扱いやすい より厳格に 情報が落ちる型変換、長さ違いの横結合、文字列から日付への cast がエラーになる 黙って結果が変わるバグを早く見つけられる
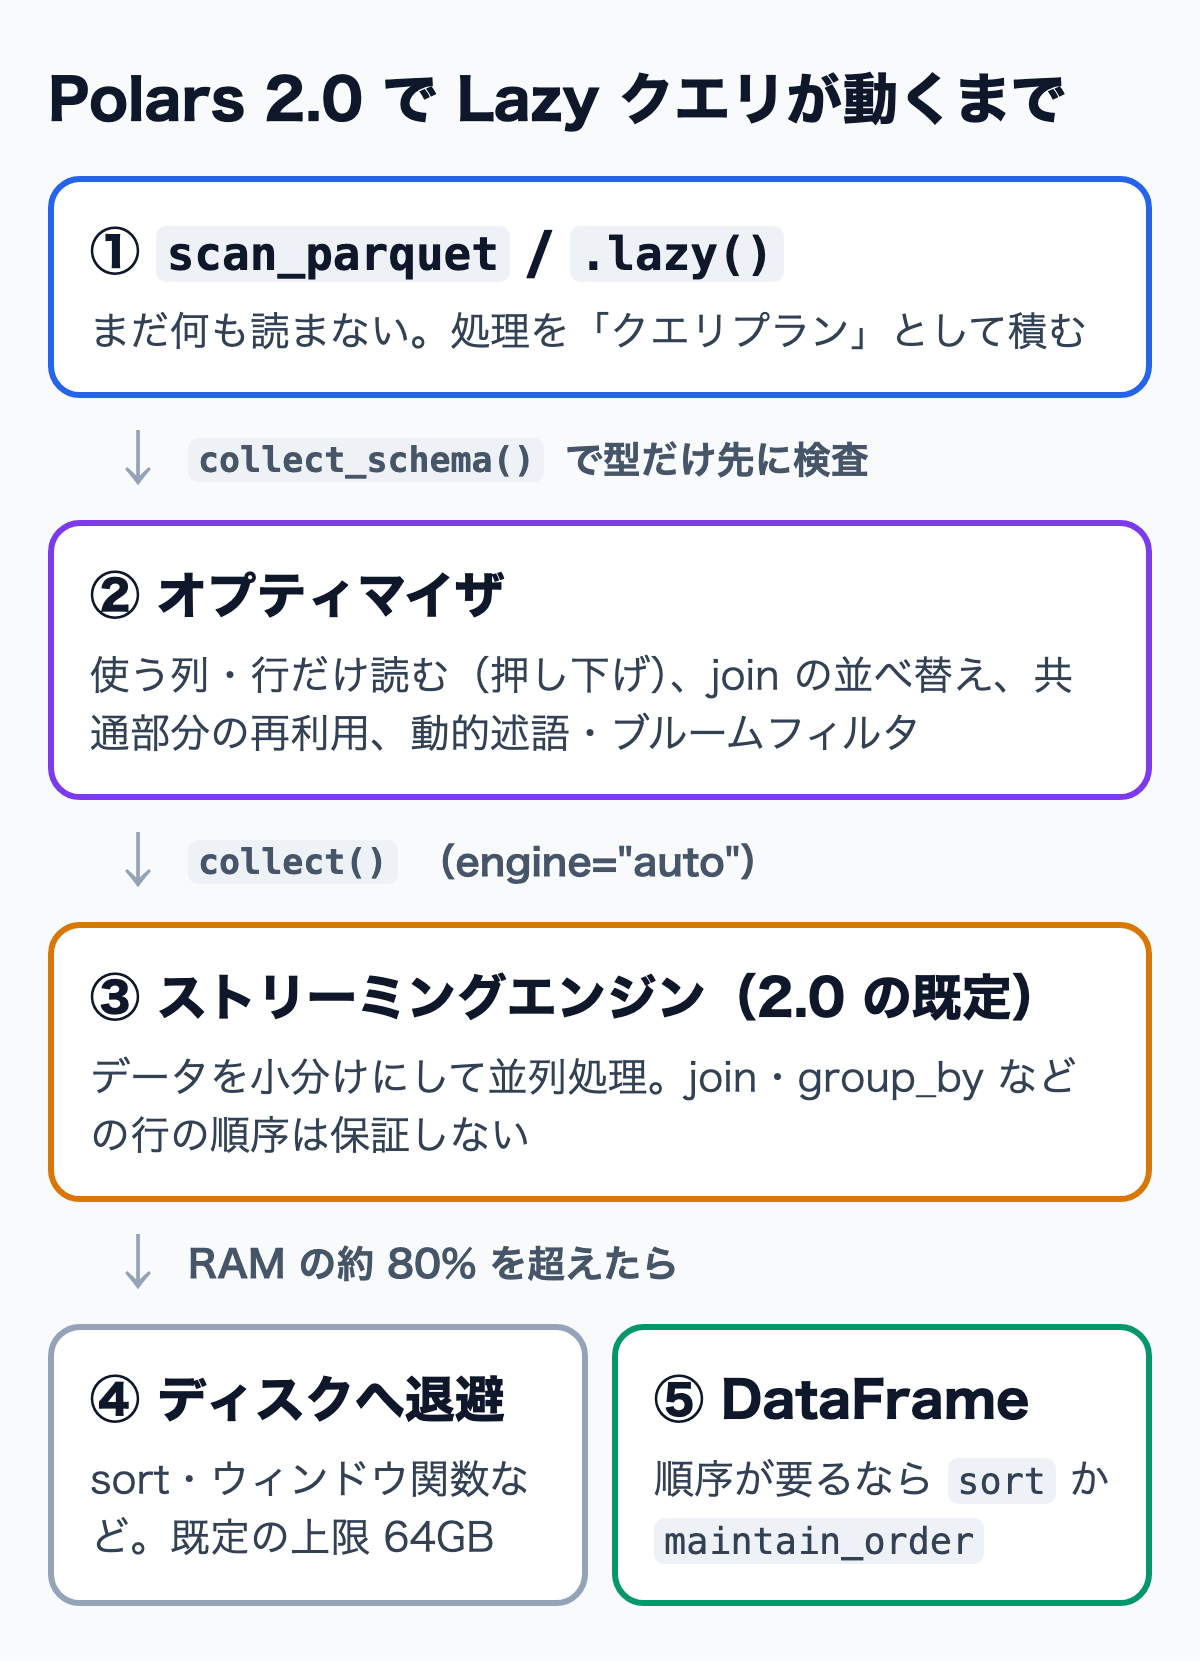
scan_parquet でクエリプランを積み、オプティマイザを経てストリーミングエンジンで実行し、メモリが足りなければディスクに退避する流れ 図: 筆者作成(Polars 公式ブログ・アップグレードガイドをもとに作図) インストールは pip install polars だけです。2026 年 10 月時点の最新版は 2.0.0 で、Python 3.10 以上が必要です5 polars と一緒に実行ファイル本体の polars-runtime-32 2.0.0 が入りました。
python3 -m venv .venv
.venv/bin/pip install polars pandas pyarrow
.venv/bin/python -c "import polars, pandas; print(polars.__version__, pandas.__version__)"
関連するツールのページ: Python 、pandas 、NumPy
理由は 2 つあります。1 つ目は、公式のベンチマークで DuckDB・DataFusion を上回ったと発表されたこと です。Polars は TPC-H・TPC-DS 由来のクエリを SQL で実行し、DuckDB 1.5.6、DuckDB 2.0 alpha、DataFusion 54.0.0 と比べました1
SF100 の全クエリ合計時間(c7a.4xlarge・16 vCPU・32GB、秒、少ないほど速い) データを表で見る SF100 の全クエリ合計時間(c7a.4xlarge・16 vCPU・32GB、秒、少ないほど速い) ベンチマーク Polars 2.0(秒) DuckDB 1.5.6(秒) DuckDB 2.0 alpha(秒) DataFusion 54.0.0(秒) TPC-H(21 クエリ) 34.63 50.17 42.12 78.04 TPC-DS(97 クエリ) 85.83 112.7 98.59 198.48
出典: 筆者集計(元データ: Polars 公式ブログ「Release of Polars 2.0」のベンチマークデータ、2026-10-06 公開、2026-10-09 取得。全エンジンが完了したクエリのみ) ただし公式も、192 vCPU の c7a.metal で小さなデータ(SF10)を扱うと、既定の Polars はスレッド数の多さが足かせになると書いています1 6
2 つ目は、開発者の関心が高いこと です。Hacker News では「Polars 2.0」の投稿が 465 ポイントを集めました7
Qiita のタグ別記事数(ストック 5 以上、直近 14 日とその前の 14 日) データを表で見る Qiita のタグ別記事数(ストック 5 以上、直近 14 日とその前の 14 日) タグ 直近 14 日(件) その前の 14 日(件) Python 21 16 AI 21 32 Security 20 12 Gemini 17 15 ChatGPT 16 19
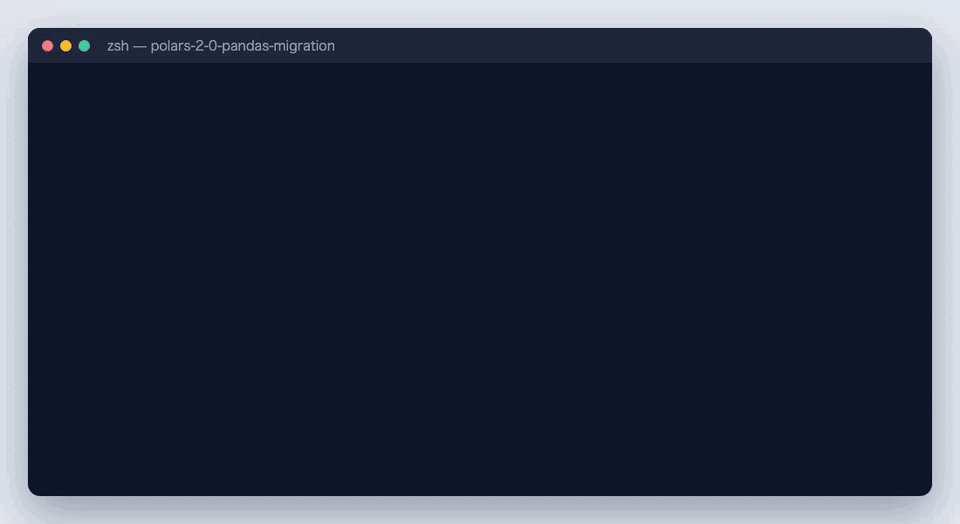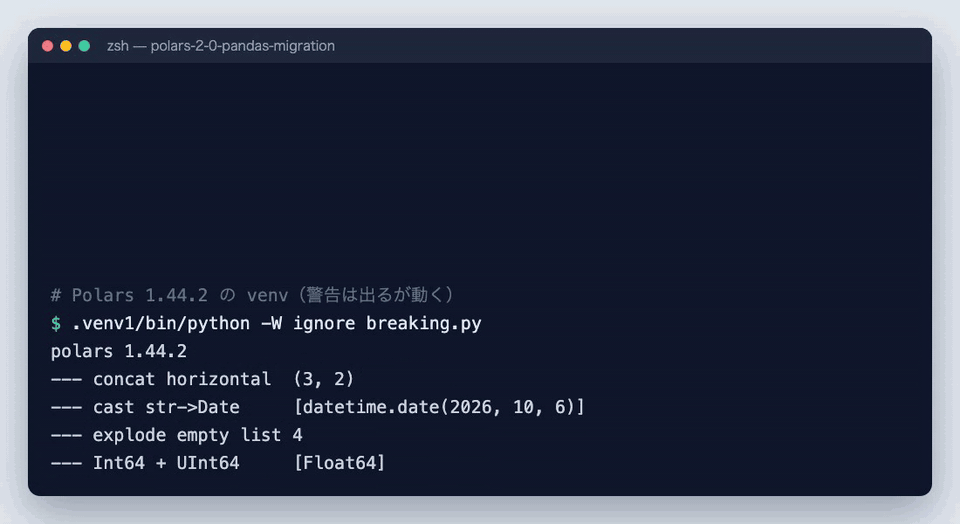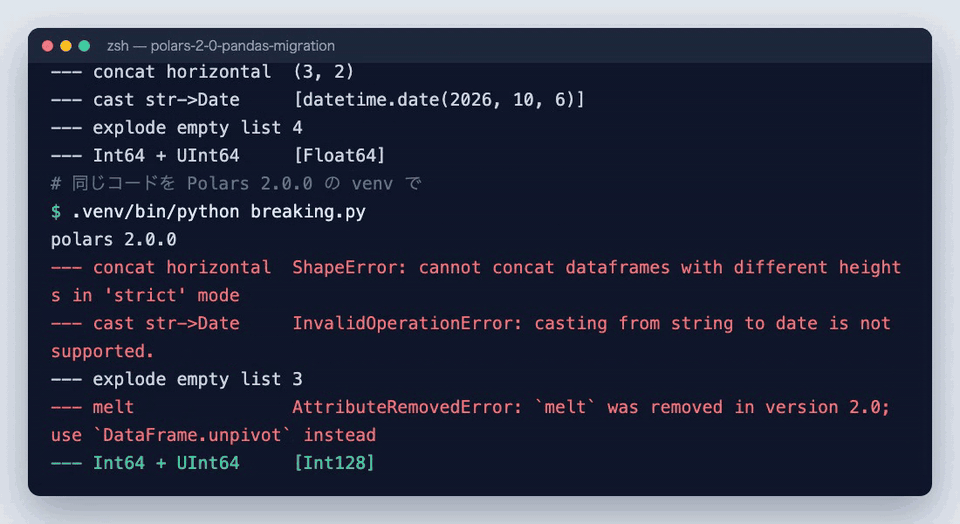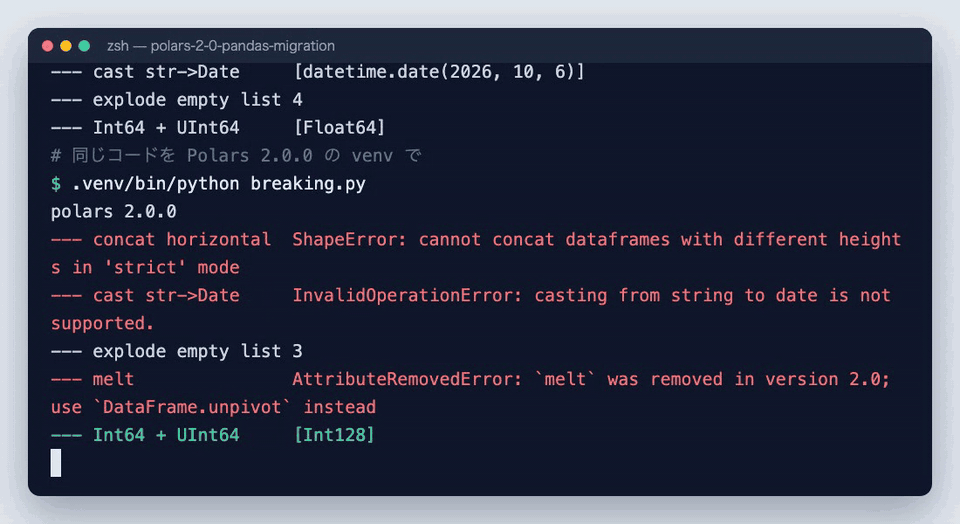
出典: 筆者集計(元データ: Qiita API v2 の記事一覧、2026-10-09 取得) 1.x で警告が出ていたコードの多くが、2.0 ではエラーになります 。エラーにならず結果だけ変わるものもあるので、そちらのほうが要注意です。筆者は同じスクリプトを Polars 1.44.2(2026 年 10 月時点の 1.x の最新版5
同じスクリプトを Polars 1.44.2 と 2.0.0 で実行し、横結合・日付の cast・melt がエラーになり、explode の行数と型が変わる様子 筆者が 2026-10-09 に macOS で実行した出力(1 行にまとめ、一部を省略) import polars as pl
df1 = pl.DataFrame({"a" : [1 , 2 , 3 ]})
df2 = pl.DataFrame({"b" : [4 , 5 ]})
pl.concat([df1, df2], how="horizontal" )
pl.Series(["2026-10-06" ]).cast(pl.Date)
pl.Series([1 ]).is_in(pl.Series([1.99 ]))
pl.DataFrame({"a" : [[1 , 2 ], [], [3 ]]}).explode("a" )
pl.DataFrame({"a" : [1 ], "b" : [2 ]}).melt(id_vars="a" )
コード 1.44.2 の結果 2.0.0 の結果 2.0 での書き方 concat(how="horizontal")(高さ違い)null で埋めて (3, 2) ShapeError埋めたいなら how="horizontal_extend" cast(pl.Date)(文字列)日付になる InvalidOperationErrorstr.to_date() / str.to_datetime()is_in(Int64 と Float64)[False]InvalidOperationErrorどちらかを明示的に cast explode(空リストあり)4 行(空が null 1 行) 3 行 前の動きは empty_as_null=True melt / with_row_count動く(非推奨の警告) AttributeRemovedErrorunpivot / with_row_indexInt64 + UInt64 Float64 Int128 型が変わる前提で後段を確認
アップグレードガイドが「黙って結果が変わりうる(Danger)」と明記している変更は、ほかにもあります3
行の順序 : Lazy の join・group_by・unpivot は順序が変わりうる。順序に頼るなら sort するか maintain_order を渡すpl.datetime / pl.repeat の列名"datetime" ではなく最初の引数の名前(例: "year")になるio.BytesIO からの読み込みbuf.seek(0) が要るCSV : ヘッダーなしの自動列名が column_1 始まりから column_0 始まりに変わる。複数ファイルの型推論は先頭 10 ファイルだけを見るread_csvscan_csv(...).collect() を呼ぶようになり、n_threads などの引数がなくなったLazyFrame.profile()
削除された API を呼ぶと、新しい例外 AttributeRemovedError・ArgumentRemovedError が代わりの API を教えてくれます2 str.explode() など一部はふつうの AttributeError / TypeError のままで、代わりの API は示されません3
順序の変化はエラーにならないので、移行でいちばん見落としやすい点です。逆順のキーを持つ 20 万行の表を left join すると、2.0 の既定では左の表の順序が保たれませんでした。
import polars as pl
left = pl.LazyFrame({"k" : list (range (200_000 ))[::-1 ], "v" : range (200_000 )})
right = pl.LazyFrame({"k" : range (200_000 ), "r" : range (200_000 )})
a = left.join(right, on="k" , how="left" ).collect()
b = left.join(right, on="k" , how="left" , maintain_order="left" ).collect()
# Polars 2.0.0
left の先頭 k: [199999, 199998, 199997]
既定        : [49999, 49997, 49986] 左と同じ順序か: False
maintain_order='left': [199999, 199998, 199997] 左と同じ順序か: True

# Polars 1.44.2(既定はインメモリエンジン)
既定        : [199999, 199998, 199997] 左と同じ順序か: True
既定の並びは実行ごとに変わりうるので、出力の値そのものに意味はありません。前のエンジンに戻したい場合は、プロセス全体なら pl.Config.set_engine_affinity("in-memory")、クエリ単位なら collect(engine="in-memory")、環境変数なら POLARS_ENGINE_AFFINITY=in-memory を使います3
pandas との最大の違いは、インデックスがなく、処理を「式(pl.col(...))」で書くこと です8
やりたいこと pandas Polars 2.0 CSV を読む pd.read_csv(path)pl.read_csv(path)(Lazy なら pl.scan_csv(path))列を選ぶ df[["a", "b"]]df.select("a", "b")行を絞る df[df["a"] > 0]df.filter(pl.col("a") > 0)列を足す df.assign(t=df["x"] * 0.1)df.with_columns(t=pl.col("x") * 0.1)欠損を埋める df["x"].fillna(0)pl.col("x").fill_null(0)(NaN は fill_nan)前の値で埋める df["x"].ffill()pl.col("x").fill_null(strategy="forward")文字列を日付に pd.to_datetime(s, format="%Y-%m-%d")pl.col("s").str.to_date("%Y-%m-%d")集計 df.groupby("k").agg(t=("x", "sum"))df.group_by("k").agg(t=pl.col("x").sum())件数 .agg(n=("id", "count")).agg(n=pl.len())並べ替え df.sort_values("x", ascending=False)df.sort("x", descending=True)結合 df.merge(s, on="k", how="left")df.join(s, on="k", how="left", maintain_order="left")縦に連結 pd.concat([a, b])pl.concat([a, b])横に連結 pd.concat([a, b], axis=1)pl.concat([a, b], how="horizontal")(高さが同じこと)縦持ちにする df.melt(id_vars="k")df.unpivot(index="k")横持ちにする df.pivot_table(index=, columns=, values=, aggfunc="sum")df.pivot(on=, index=, values=, aggregate_function="sum")条件で値を分ける np.where(c, "high", "low")pl.when(c).then(pl.lit("high")).otherwise(pl.lit("low"))グループ内で 1 つずらす df.groupby("k")["x"].shift(1)pl.col("x").shift(1).over("k")移動平均 s.rolling(2).mean()pl.col("x").rolling_mean(window_size=2)ビン分け pd.cut(s, bins)pl.col("x").bin_intervals(breaks, labels=[...])(2.0 で cut は非推奨)重複を除く df.drop_duplicates("k")df.unique(subset="k", maintain_order=True)行番号を振る df.reset_index()df.with_row_index()(列名は index)行ごとの関数 df.apply(f, axis=1)まず式で書く。最後の手段が map_elements 相互変換 — df.to_pandas() / pl.from_pandas(pdf)
2.0 では cut() / qcut() が非推奨になり、bin_intervals()・bin_quantiles()・bin_ranks() に置き換わりました3 cut と同じ区切りにするには right_closed=True を付けます。
店舗ごとの売上を集計する典型的な pandas のコードを、Polars 2.0 に書き換えました。
import pandas as pd
import polars as pl
data = {
"order_id" : [1 , 2 , 3 , 4 , 5 , 6 ],
"store" : ["渋谷" , "新宿" , "渋谷" , "池袋" , "新宿" , "渋谷" ],
"ordered_at" : ["2026-10-01" , "2026-10-01" , "2026-10-02" , "2026-10-02" , "2026-10-03" , "2026-10-03" ],
"amount" : [1200 , 800 , None , 1500 , 900 , 2000 ],
}
pdf = pd.DataFrame(data)
pdf["ordered_at" ] = pd.to_datetime(pdf["ordered_at" ])
pdf["amount" ] = pdf["amount" ].fillna(0 )
p = (pdf[pdf["amount" ] > 0 ]
.groupby("store" , as_index=False )
.agg(total=("amount" , "sum" ), n=("order_id" , "count" ))
.sort_values("total" , ascending=False ))
q = (pl.DataFrame(data)
.with_columns(pl.col("ordered_at" ).str .to_date(),
pl.col("amount" ).fill_null(0 ))
.filter (pl.col("amount" ) > 0 )
.group_by("store" )
.agg(total=pl.col("amount" ).sum (), n=pl.len ())
.sort("total" , descending=True ))
print (q)
shape: (3, 3)
┌───────┬───────┬─────┐
│ store ┆ total ┆ n   │
│ ---   ┆ ---   ┆ --- │
│ str   ┆ i64   ┆ u32 │
╞═══════╪═══════╪═════╡
│ 渋谷  ┆ 3200  ┆ 2   │
│ 新宿  ┆ 1700  ┆ 2   │
│ 池袋  ┆ 1500  ┆ 1   │
└───────┴───────┴─────┘
pandas 3.0.6 の結果も同じ値でしたが、total 列は 3200.0 のように小数になりました。欠損(None)を含む整数列を float にするためです。Polars は欠損を null で持つので、整数のまま(i64)です。
2.0 で追加された Map 型は、キーと値の組を列に持てます。SQL も同じエンジンで実行できます1
df = pl.DataFrame({
"user" : ["alice" , "bob" , "carol" ],
"scores" : pl.Series([{"math" : 90 , "art" : 75 }, {"math" : 60 }, {}],
dtype=pl.Map(pl.String, pl.Int64)),
})
df.select("user" , math=pl.col("scores" ).map .get("math" ),
has_art=pl.col("scores" ).map .contains_key("art" ))
orders = pl.DataFrame({"store" : ["渋谷" , "新宿" , "渋谷" ], "amount" : [1200 , 800 , 2000 ]})
pl.sql("SELECT store, SUM(amount) AS total FROM orders GROUP BY store ORDER BY total DESC" , eager=True )
Lazy API は、処理を先に「クエリプラン」として組み立て、最後の collect() でまとめて実行する書き方 です。公式の pandas 移行ガイドも、Lazy を既定にすることを勧めています8 collect() がストリーミングエンジンで動くので、Lazy にする効果がさらに大きくなりました。
import polars as pl
lf = (
pl.scan_parquet("orders.parquet" )
.with_columns(pl.col("ordered_at" ).str .to_date())
.filter (pl.col("ordered_at" ) >= pl.date(2026 , 7 , 1 ))
.join(pl.scan_csv("stores.csv" ), on="store_id" , how="left" )
.group_by("pref" )
.agg(total=pl.col("amount" ).sum (), n=pl.len ())
)
print (lf.collect_schema())
print (lf.explain())
print (lf.sort("pref" ).collect())
explain() の出力(抜粋)を見ると、Parquet の 5 列のうち必要な 3 列だけを読む計画になっています。
Schema({'pref': String, 'total': Int64, 'n': UInt32})
AGGREGATE[maintain_order: false]
  [col("amount").sum().alias("total"), len().alias("n")] BY [col("pref")]
  ...
        FILTER col("ordered_at") >= 2026-07-01
  ...
              Parquet SCAN [orders.parquet]
              PROJECT 3/5 COLUMNS
              ESTIMATED ROWS: 10000000
collect_schema() は、データを読まずに列名と型だけを解決します。公式ブログは、これを人にも AI エージェントにも速いフィードバックになると紹介しています1 2
書き間違い collect_schema()存在しない列 amount_yen を参照 ColumnNotFoundError(正しい列名の一覧つき)文字列の列を pl.date(...) と比較 InvalidOperationError整数の列を is_in([1.5, 2.0]) で探す InvalidOperationError文字列の列を cast(pl.Date) 通る (head(1).collect() で初めて InvalidOperationError)
すべてが実行前に見つかるわけではありません。cast のエラーは実行時に出るので、少ない行数で head(n).collect() まで流す確認も合わせて行うのが確実です。
手元の測定では、Polars 2.0 の Lazy API(ストリーミング)が最も速く、メモリも最も少なく済みました 。同じ集計を Polars 2.0 のインメモリエンジンや 1.44.2 で動かすと、2.0 の既定より約 2.5 倍遅くなりました。
測定条件は次のとおりです。
マシン: Intel Mac(Core i7-1068NG7、8 論理コア、メモリ 32GB)、macOS 26.6.2、Python 3.14.7
バージョン: pandas 3.0.6、Polars 2.0.0、Polars 1.44.2(すべて venv)
データ: 乱数で作った注文 1,000 万行(5 列。CSV 351MB、Parquet 88MB)と店舗マスタ 1,000 行
処理: 読み込み → 日付に変換 → 2026-07-01 以降に絞る → 店舗マスタと left join → 都道府県 × 月で合計と件数を集計 → 並べ替え(全条件で結果が一致することを確認)
計り方: 条件ごとに別プロセスで 10 回実行し、最速の値。ファイルキャッシュは温まった状態。ピークメモリは ru_maxrss の中央値(Python 本体とライブラリの分を含む)
注意: 他の処理も動いている手元の PC で測ったため、ばらつきが大きく、中央値は最速値の 1.4〜2 倍程度でした。傾向を見るための参考値です
1,000 万行の集計にかかった時間(10 回中の最速、秒、少ないほど速い) データを表で見る 1,000 万行の集計にかかった時間(10 回中の最速、秒、少ないほど速い) 条件 CSV(秒) Parquet(秒) pandas 3.0.6 7.29 3.36 Polars 2.0 Eager(read_*) 1.97 1.69 Polars 2.0 Lazy・インメモリ 1.93 1.65 Polars 1.44.2 Lazy(既定) 1.92 1.59 Polars 2.0 Lazy(既定=ストリーミング) 0.78 0.65
出典: 筆者計測(2026-10-09、Intel Mac Core i7-1068NG7・32GB、macOS 26.6.2。測定条件は本文) 1,000 万行の集計でのピークメモリ(ru_maxrss の中央値、MB) データを表で見る 1,000 万行の集計でのピークメモリ(ru_maxrss の中央値、MB) 条件 CSV(MB) Parquet(MB) pandas 3.0.6 1,875 1,774 Polars 2.0 Eager(read_*) 1,102 1,088 Polars 2.0 Lazy・インメモリ 800 708 Polars 1.44.2 Lazy(既定) 800 697 Polars 2.0 Lazy(既定=ストリーミング) 633 401
出典: 筆者計測(2026-10-09、Intel Mac Core i7-1068NG7・32GB、macOS 26.6.2。測定条件は本文) 結果から言えることは 3 つです。
書き換えるなら Lazy まで書き換える 。Eager(read_* で全部読む)のままでは、Polars 2.0 でも 1.x の Lazy と同程度でした1.x の Lazy から 2.0 に上げるだけで速くなる 。1.44.2 の Lazy(インメモリ)に比べ、2.0 の既定は CSV・Parquet とも約 2.5 倍速く、Parquet ではメモリが約 4 割減りましたpandas との差は CSV で大きい 。pandas 3.0.6 に比べ、CSV で約 9 倍、Parquet で約 5 倍速くなりました
pandas 側は pd.to_datetime に format を渡しています。渡さない最初の試行では、Parquet の場合 28 秒かかりました。pandas のまま速くしたいなら、まず型と書式を明示するのが効きます。測定に使ったスクリプトは次のとおりです(Polars 部分)。
import polars as pl
def query (o, s ):
return (o.with_columns(pl.col("ordered_at" ).str .to_date())
.filter (pl.col("ordered_at" ) >= pl.date(2026 , 7 , 1 ))
.join(s, on="store_id" , how="left" )
.group_by("pref" , month=pl.col("ordered_at" ).dt.month())
.agg(total=pl.col("amount" ).sum (), n=pl.len ())
.sort("pref" , "month" ))
out = query(pl.scan_parquet("orders.parquet" ), pl.scan_csv("stores.csv" )).collect()
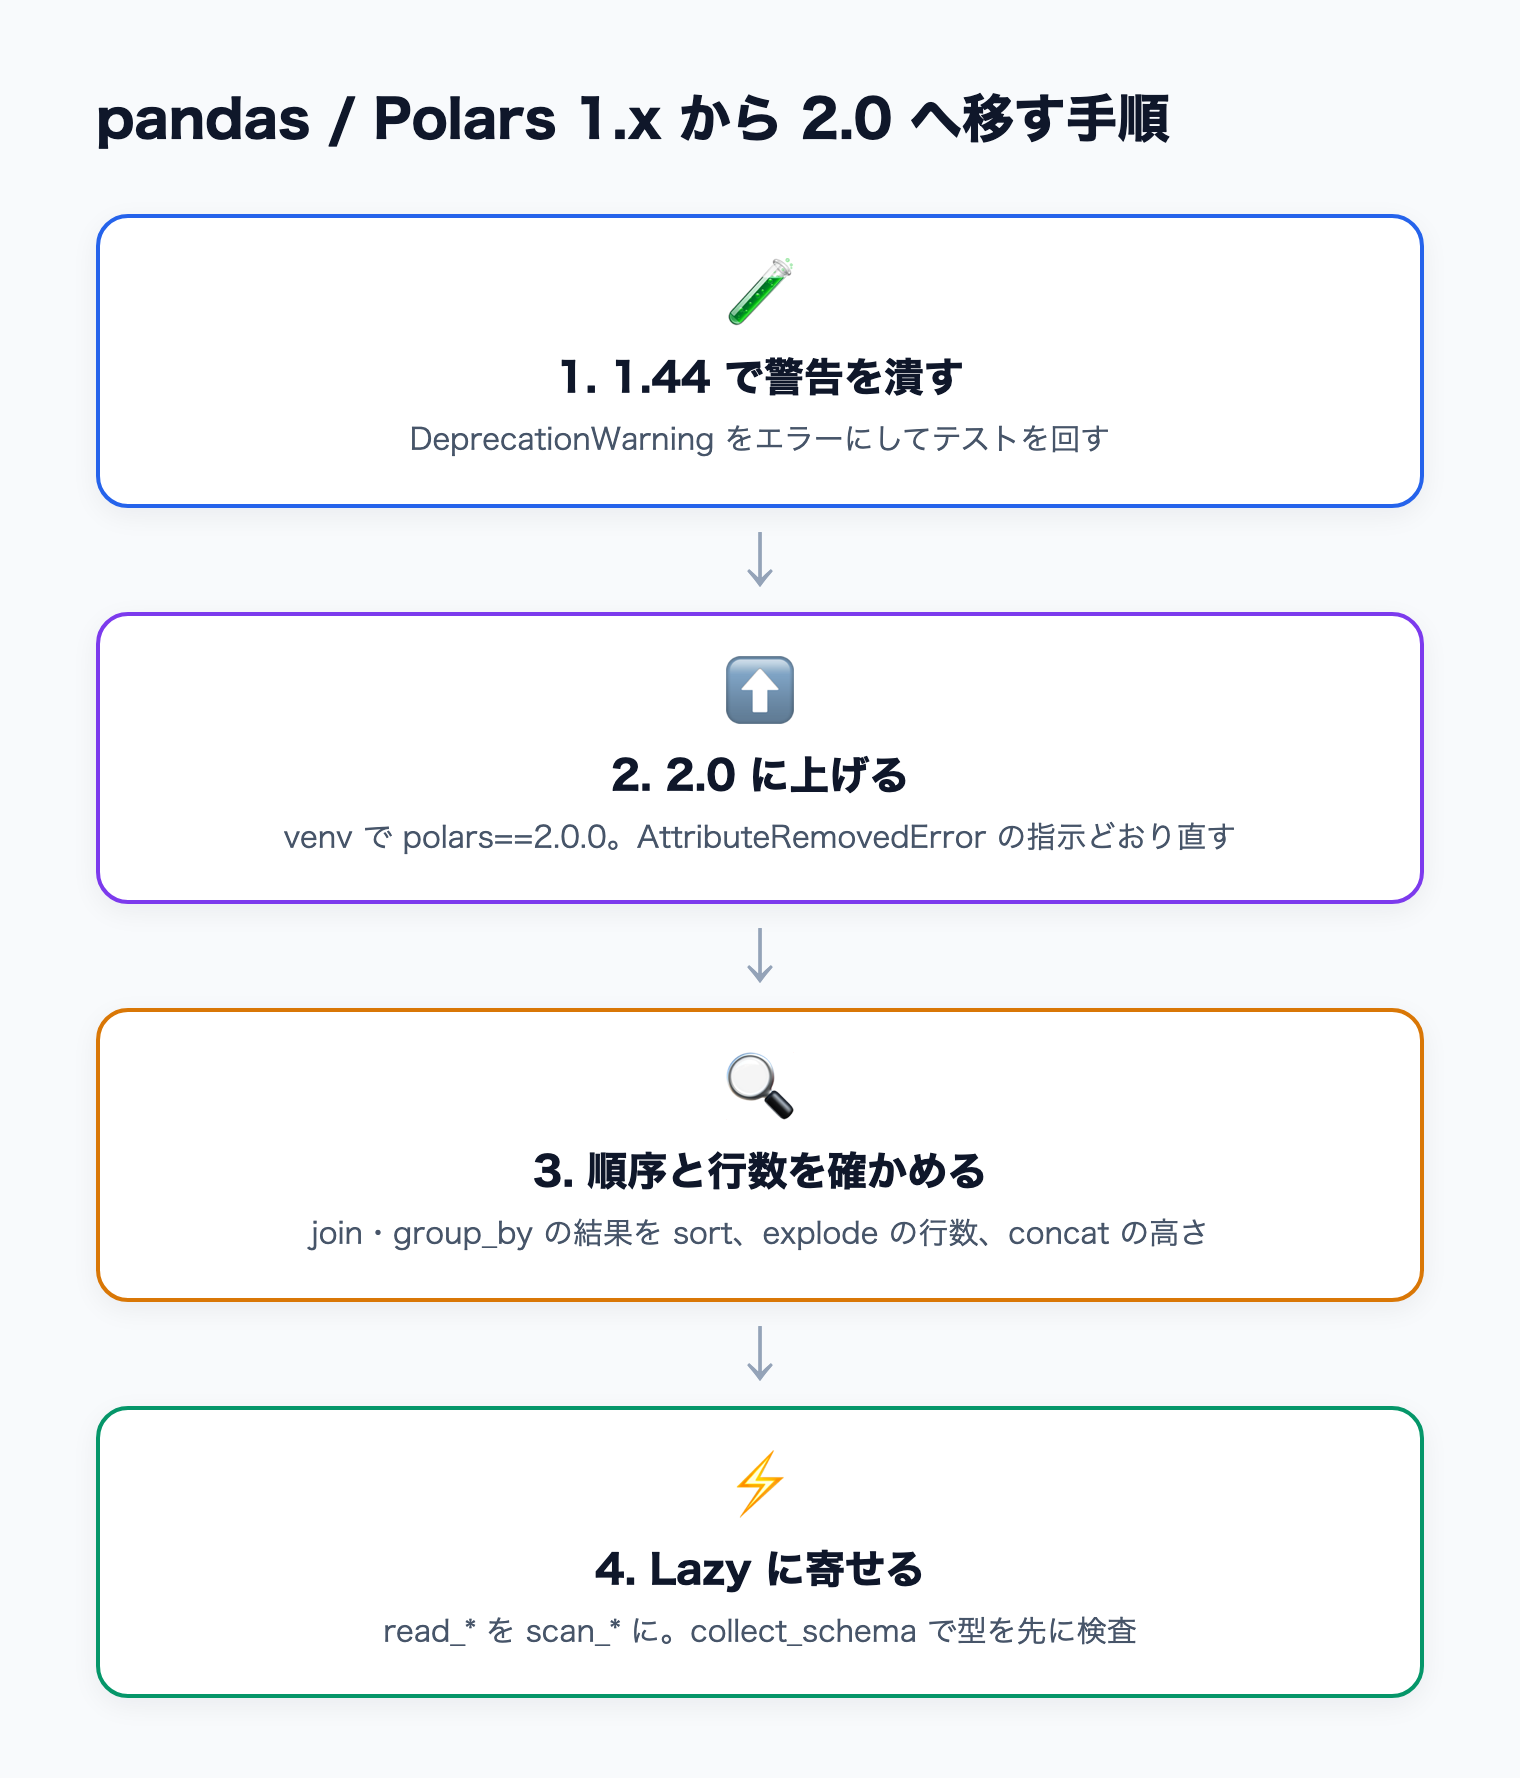
移行は「1.x で警告を潰す → 2.0 に上げる → 順序と行数を確かめる → Lazy に寄せる」の順に進めると安全です 。
1.44 で警告を潰し、2.0 に上げ、順序と行数を確かめ、Lazy に寄せる 4 段階の手順 図: 筆者作成 1.44.2 では、2.0 で消える書き方の多くに DeprecationWarning が出ます。筆者の確認では、横結合・日付の cast・explode・melt・with_row_count で警告が出ました。警告をエラーにしてテストを回せば、2.0 に上げる前に直す場所が分かります。
pip install "polars==1.44.2"
python -W error::DeprecationWarning -m pytest
DeprecationWarning: Casting from String to Date is deprecated and will be removed in Polars 2.0.
Use `str.to_date()` instead.
pip install "polars==2.0.0" で上げ、テストを回します。AttributeRemovedError と ArgumentRemovedError は、代わりの API と引数名をメッセージに含みます2 join_nulls=True は nulls_equal=True に、with_row_count() は with_row_index() に変わります3
アップグレードガイドの Danger の項目(行の順序、explode の行数、Int128 への型の変化、pl.datetime の列名、BytesIO の位置)を、コードの中から検索して確かめます3 sort() か maintain_order を入れます。
pandas からの移行では、対応表で 1 行ずつ置き換えたあと、read_* を scan_* に変えて最後に collect() します。外部ライブラリ(scikit-learn や可視化)に渡す直前で to_pandas() すれば、全部を一度に移す必要はありません。
Polars 2.0 はエラーが具体的なので、AI エージェントに「テストを回してエラーに従って直す」作業を任せやすい ライブラリです。公式ブログも、厳格さが AI による開発の反復を速くすると書いています1 Claude Code などに任せるときは、次の 4 点を指示に入れると手戻りが減ります。
バージョンを固定して伝える : 「Polars 2.0.0。melt や cast(pl.Date) ではなく unpivot・str.to_date() を使う」のように、2.0 の書き方を指示に書いておくアップグレードガイドを読ませる : https:/ を最初に読ませ、Danger の項目を検索させるcollect_schema() と小さな collect() で確かめさせるhead(100).collect() まで流させる順序の比較はソートしてから : 移行前後の結果を比べるテストでは、assert_frame_equal(a.sort(keys), b.sort(keys)) のように並べ替えてから比べさせる
Polars の map_elements は、式で書けるラムダを渡すと PolarsInefficientMapWarning で書き換え案を出します(筆者の確認では lambda v: v * 2 に対し pl.col("a") * 2 を提案)。エージェントにも「警告は無視せず、提案に従う」と伝えておくとよいでしょう。プロジェクトの決まりは CLAUDE.md・AGENTS.md に書いておくと毎回伝える必要がなくなり、Claude Code のスキル にすればほかのリポジトリでも使い回せます。
## Polars
- バージョンは polars==2.0.0。1.x の API(melt, with_row_ count, cast(pl.Date))は使わない
- 新しい処理は scan_* → collect() の Lazy API で書く
- join / group_ by の結果の順序に頼らない。必要なら sort か maintain_order
- 変更したら collect_ schema() と head(100).collect() で確認してから pytest
症状 原因 対処 テストが通ったり落ちたりする Lazy の結果の行の順序が実行ごとに変わる 比較の前に sort。順序が要る処理は maintain_order InvalidOperationError: casting from string to date2.0 で文字列 → 日付の cast が廃止 str.to_date() / str.to_datetime()ShapeError: cannot concat dataframes with different heights横結合が高さの一致を要求 元データの欠けを調べる。埋めるなら how="horizontal_extend" 行数が 1.x より減った explode が空リストを 0 行にするexplode(..., empty_as_null=True)read_parquet(buf) がフッターのエラーBytesIO が先頭に戻らない読む前に buf.seek(0) profile() がない2.0 で削除 代わりは現時点でなし(公式は OSS 向けのプロファイリングを準備中)3 192 コアなど多コア機で小さなクエリが遅い 多スレッド時の固定のオーバーヘッド 公式は次のリリースで直す予定と説明1
Polars 2.0(2026-10-06)は、Lazy の既定がストリーミングエンジンになり、型や結合のルールが厳格になったリリース
エラーになる変更より、行の順序・explode の行数・型の変化のように黙って結果が変わる変更 に注意する
pandas からは対応表で置き換え、scan_* → collect() の Lazy まで書き換えると効果が大きい。手元の 1,000 万行では pandas 3.0.6 比で CSV 約 9 倍、Parquet 約 5 倍速かった(筆者計測)
移行は Polars 1.44.2 で DeprecationWarning をエラーにするところから始める
AI エージェントには、バージョン・アップグレードガイド・collect_schema() での確認・ソートしてからの比較を指示する
次にやることは、手元のプロジェクトで python -W error::DeprecationWarning -m pytest を Polars 1.44.2 で回すことです。
1.x で非推奨の警告が出ていたコードは、多くがエラーになります。たとえば melt、with_row_count、文字列の cast(pl.Date)、高さの違う横結合です3 explode の行数のように、エラーにならず結果だけ変わる変更もあります。
戻せます。pl.Config.set_engine_affinity("in-memory") でプロセス全体、collect(engine="in-memory") でクエリ単位、環境変数 POLARS_ENGINE_AFFINITY=in-memory でも切り替えられます3
1,000 万行規模の集計を繰り返すなら、移す価値があります。手元の測定では、Lazy API で書き直すと pandas 3.0.6 より CSV で約 9 倍速く、ピークメモリは 3 分の 1〜4 分の 1 でした。小さなデータや、pandas 前提のライブラリとのやり取りが多い処理は、to_pandas() で境目を作って段階的に移すのが現実的です。
Polars の公式ベンチマークでは、16 vCPU のマシンで TPC-H・TPC-DS 由来のクエリの合計時間が DuckDB 1.5.6・2.0 alpha より短くなりました1
キーと値の組を 1 つの列に持つ型です。Parquet や Arrow の Map 列は、1.x では List(Struct) として読まれていましたが、2.0 では pl.Map として読まれ、map.get()・map.contains_key()・map.keys() などで扱えます1 3