Claude Opus 5.5 と Sonnet 5.5 の使い分けは、日常の実装・バグ修正・資料作りは Sonnet 5.5、長時間走らせるエージェント作業や設計判断が要る仕事は Opus 5.5 が基本です。料金は 100 万トークンあたり Opus 5.5 が入力 $4 / 出力 $20、Sonnet 5.5 が $2 / $10 でちょうど 2 倍の差です。コンテキスト長はどちらも 1M トークン、最大出力は 128K トークンで同じです1 2 3
Claude Opus 5.5 と Claude Sonnet 5.5 は、Anthropic の「Claude 5.5」世代のモデルです。Opus 5.5 は世代の 1 番目、Sonnet 5.5 は 2 番目として出ました2 3 1
主な仕様を、Claude Platform のドキュメントの値でまとめます1
項目 Claude Opus 5.5 Claude Sonnet 5.5 発表日 2026-09-22 2026-09-28 API のモデル ID claude-opus-5-5claude-sonnet-5-5Amazon Bedrock の ID anthropic.claude-opus-5-5anthropic.claude-sonnet-5-5料金(入力 / 出力、100 万トークンあたり) $4 / $20 $2 / $10 キャッシュ読み取り $0.20(入力単価の 5%) $0.20(入力単価の 10%) コンテキスト長 1M トークン 1M トークン 最大出力(同期 API) 128K トークン 128K トークン 思考(thinking) 適応型・常にオン 適応型(between_tools で事前の思考を止められる) API の既定の effort mediumhigh相対的な待ち時間 Moderate(中程度) Fast(速い) 信頼できる知識の期限 2026 年 6 月 2026 年 6 月
表のとおり、文脈の長さと出力の上限は同じで、違うのは料金・速さ・思考の扱い です。モデル ID は日付の付かない形で、これ自体が固定のスナップショットです1
effort(エフォート)は、モデルがどれだけ考えて検証するかを決める設定です。low・medium・high・xhigh・max の 5 段階があり、上げるほど丁寧になりますが、トークンも時間も増えます4
注目される理由は、Opus 5.5 が上位モデルの Fable 5.1 並みの性能を、Opus 5 より 40% 安く出す と発表されたからです2 2
検索の数字にも表れています。Google トレンド(日本・過去 90 日)で、直近 4 週の平均をその前 8 週の平均と比べました。その結果、「Opus 5.5」は 0.2 から 13.2 に、「Sonnet 5.5」は 0.1 から 3.8 に増えています5
Google トレンドの検索の相対値(日本・直近 4 週平均とその前 8 週平均) データを表で見る Google トレンドの検索の相対値(日本・直近 4 週平均とその前 8 週平均) 語 前 8 週 直近 4 週 Opus 5.5 0.2 13.2 Sonnet 5.5 0.1 3.8 GPT-6 4.9 20.3
出典: Google トレンド(日本・過去 90 日、2026-10-05 取得)の相対値。同じ回に基準語として入れた GitHub Copilot の直近 4 週平均は 25.5 急上昇の関連語には「opus 5.5 vs astra」「fable 5.1」が並び、Claude Code の関連語では「claude code モデル 変更」が伸びています5
料金は、入出力とも Opus 5.5 が Sonnet 5.5 のちょうど 2 倍 です。ただしキャッシュ読み取りはどちらも 100 万トークンあたり $0.20 で同じです6 6
Claude API の料金(USD / 100 万トークン、標準の速度) データを表で見る Claude API の料金(USD / 100 万トークン、標準の速度) モデル 入力($) 出力($) Fable 5.1 10 50 Opus 5 5 25 Opus 5.5 4 20 Sonnet 5.5 2 10 Haiku 4.5 1 5
出典: Anthropic, Claude Platform Docs「Pricing」(2026-10-05 参照) 単価以外の料金のルールも、公式の料金表で確かめておきます6
項目 Opus 5.5 Sonnet 5.5 5 分キャッシュの書き込み $5 $2.50 1 時間キャッシュの書き込み $8 $4 キャッシュ読み取り $0.20 $0.20 Batch API(入力 / 出力) $2 / $10 $1 / $5 Fast mode(入力 / 出力) $8 / $40 対象外
長い文脈の割増はない : 1M トークンの範囲は全体が通常の単価です。90 万トークンの依頼も 9,000 トークンの依頼と同じ単価です6 Batch API は 50% 引き : 急がない一括処理なら、入力も出力も半額になります6 US 内での推論は 1.1 倍 : inference_geo: "us" を指定すると全項目が 1.1 倍になります6 Fast mode は Opus のみ : 最大 2.5 倍速くなる研究プレビューで、Sonnet では使えません7
API の費用は「(入力トークン数 × 入力単価 + 出力トークン数 × 出力単価)÷ 100 万」で計算します。キャッシュを使う場合は、キャッシュから読んだ分だけ単価をキャッシュ読み取りの値に置き換えます。
ここでは、1 回あたり入力 50,000 トークン・出力 5,000 トークンの依頼を、1 日に 100 回送る場合を考えます。
キャッシュなし
Opus 5.5: (50,000 × $4 + 5,000 × $20) ÷ 1,000,000 = $0.30。100 回で $30.00
Sonnet 5.5: (50,000 × $2 + 5,000 × $10) ÷ 1,000,000 = $0.15。100 回で $15.00
入力のうち 40,000 トークンをキャッシュから読む場合
Opus 5.5: (10,000 × $4 + 40,000 × $0.20 + 5,000 × $20) ÷ 1,000,000 = $0.148。100 回で $14.80
Sonnet 5.5: (10,000 × $2 + 40,000 × $0.20 + 5,000 × $10) ÷ 1,000,000 = $0.078。100 回で $7.80
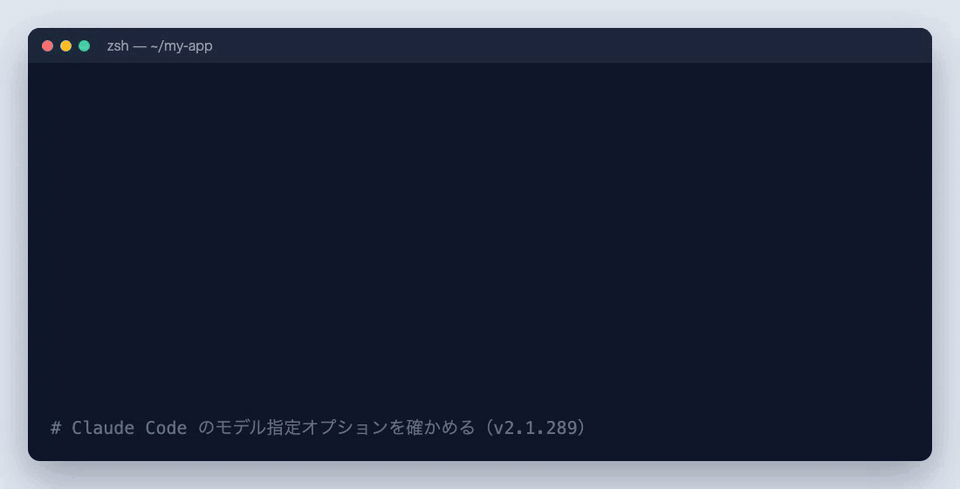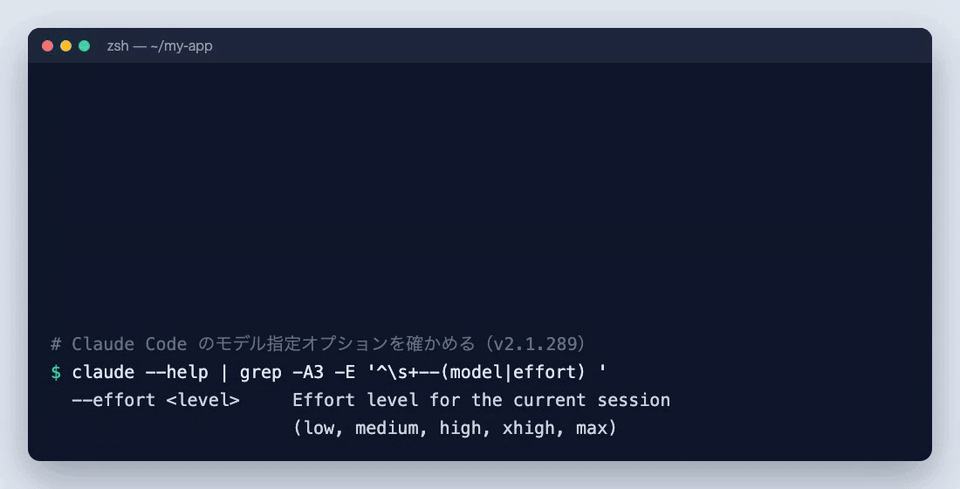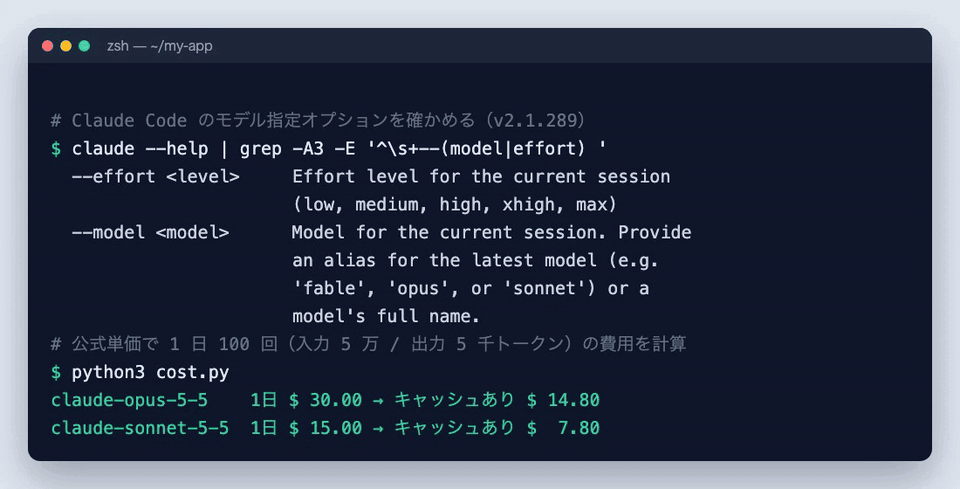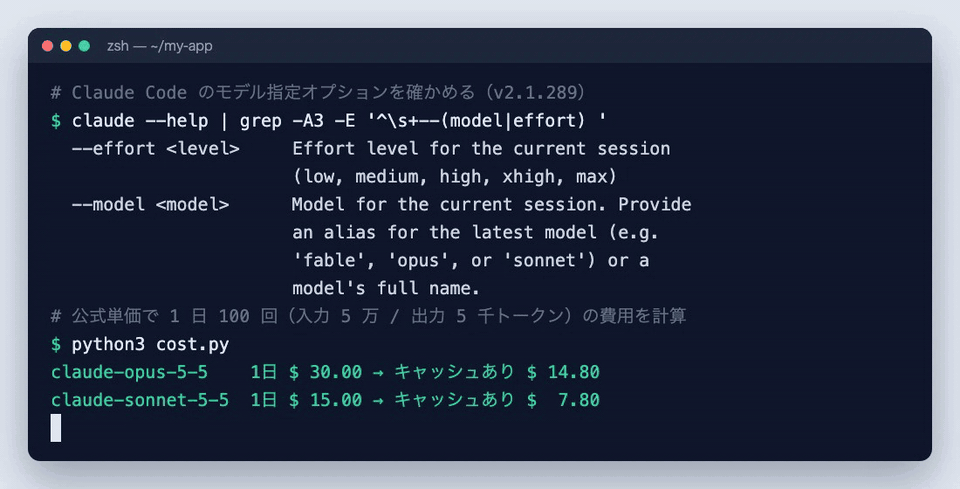
キャッシュを使うと、どちらもおよそ半額になります。なお、この計算はキャッシュの書き込み料金(最初の 1 回だけ発生)を省いた概算です。同じ計算を Python で書いて実行した結果が次の GIF です。
Claude Code の --model と --effort のヘルプを確かめ、公式単価で Opus 5.5 と Sonnet 5.5 の 1 日の費用を計算した実行結果 筆者が macOS・Claude Code v2.1.289 で実行した出力(空白の幅のみ詰めています)
PRICE = {
"claude-opus-5-5" : (4.0 , 20.0 , 0.20 ),
"claude-sonnet-5-5" : (2.0 , 10.0 , 0.20 ),
}
def cost (model, inp, out, cached=0 ):
i, o, c = PRICE[model]
return ((inp - cached) * i + cached * c + out * o) / 1_000_000
for m in PRICE:
nocache = cost(m, 50_000 , 5_000 ) * 100
cached = cost(m, 50_000 , 5_000 , cached=40_000 ) * 100
print (f"{m:18s} 1日 ${nocache:6.2 f} → キャッシュあり ${cached:6.2 f} " )
ただし、1 タスクあたりの費用は単価だけでは決まりません 。Anthropic は、Opus 5.5 は既定の設定で Opus 5 より 40% 安く済むと説明しています2 3
ベンチマークでは、Sonnet 5.5 は多くの項目で Opus 5.5 に迫り、Terminal-Bench 4.0 では上回っています 3
Claude Sonnet 5.5 発表時のベンチマーク(%) データを表で見る Claude Sonnet 5.5 発表時のベンチマーク(%) ベンチマーク Sonnet 5.5(%) Opus 5.5(%) Sonnet 5(%) Terminal-Bench 4.0 70.6 66.4 10.3 CursorBench 4.0 55.5 57.8 34.1 FrontierCode 1.1 46.2 54.4 42.4 OSWorld 2.1 80.1 81.8 57
出典: Anthropic「Introducing Claude Sonnet 5.5」(2026-09-28)の比較表。Opus 5.5 の Terminal-Bench は xhigh、Sonnet 5.5 の FrontierCode は Max effort の値 数字を読むときの注意点が 3 つあります。
effort の条件がそろっていない : Opus 5.5 の発表では、特に断りのない値は max effort で測っています。Terminal-Bench 4.0 だけは xhigh です2 3 Anthropic 自身も「Opus のほうが強い」としている : 発表には、複雑で判断の続く仕事では Opus 5.5 がはっきり強いと書かれています3 既定の effort でも差がある : Opus 5.5 は既定(medium)でも CursorBench 4.0 で 52.5%、FrontierCode で 54.6% を出したと発表されています2
「opus 5.5 vs astra」で調べる人のために、Opus 5.5 の発表ページの比較を整理します2
ベンチマーク Opus 5.5 Fable 5.1 Opus 5 GPT-6 Astra Terminal-Bench 4.0 66.4% 55.8% 52.3% 57.9% FrontierCode v1.1 54.4% 50.3% 48.0% 53.3% CursorBench 4.0 57.8% 51.8% 46.6% — GDPval-AA v2.1(Elo) 1846 1735 1708 1542 AutomationBench 40.0% 31.4% 26.9% 41.4% Terminal-Bench-Science 0.1 58.7% 52.6% 29.0% 64.6%
GPT-6 Astra の値は OpenAI の公表値を Anthropic が転記したものです2 2
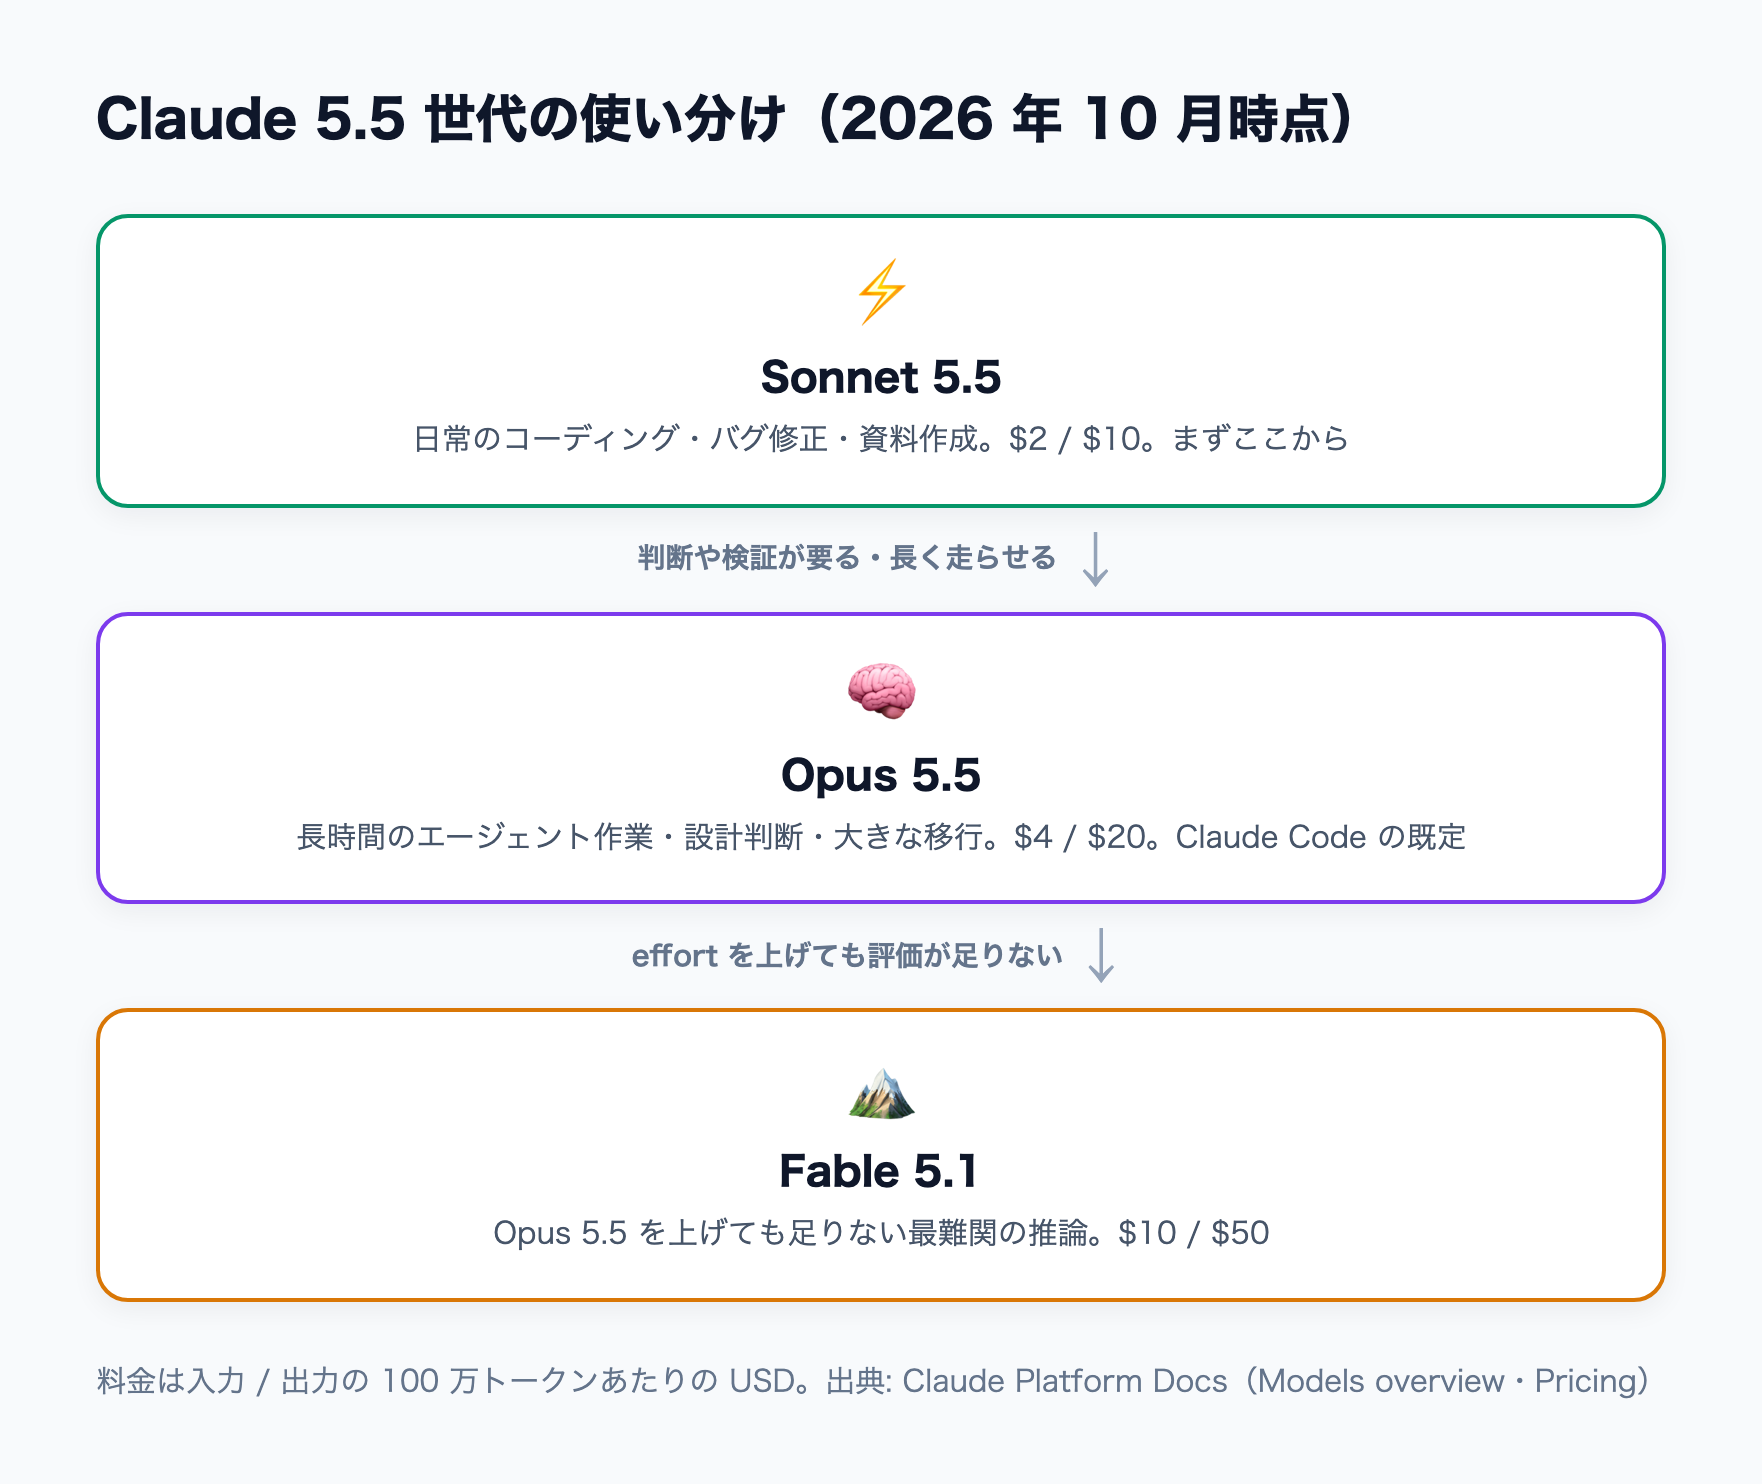
Fable 5.1 は Opus より上のモデルで、料金は $10 / $50 です1 まず Opus 5.5 から始め、effort を上げても評価が足りないときに Fable 5.1 を使う よう勧めています1
Claude Code でモデルを変更するいちばん早い方法は、セッションの中で / を実行することです8 8 claude update で更新します8
/model                # ピッカーを開く
/model sonnet         # Sonnet 5.5 に切り替え(既定としても保存)
/model opus           # Opus 5.5 に切り替え
/model claude-opus-5-5  # フルネームで固定
ピッカーでは、Enter で切り替えて既定に保存 、s でこのセッションだけ切り替え8 / のように直接打つと Enter と同じ扱いで、ユーザー設定の model に書き込まれます。今だけ試したいときは、ピッカーを開いて s を押します。
エイリアス(別名)の opus と sonnet は、Anthropic API では Opus 5.5 と Sonnet 5.5 を指します。ただし Amazon Bedrock や Google Cloud では sonnet が Sonnet 4.5 を指すなど、提供元によって違います8 claude-sonnet-5-5 のようにフルネームを使います。
/ 以外の方法もあり、上にあるものほど優先されます8
セッション中の /
起動時の claude --model <エイリアスか名前>
環境変数 ANTHROPIC_MODEL
設定ファイル(~/ など)の model
新しいセッションの既定を決める環境変数 ANTHROPIC_DEFAULT_MODEL
チームで決めたモデルを使うなら、プロジェクトの .claude/ に書くのが確実です。
{
"model" : "sonnet" ,
"modelSettings" : {
"claude-opus-5-5" : { "effortLevel" : "high" }
}
}
modelSettings はモデルごとに effort を保存する設定で、v2.1.251 以降で使えます8 high で動かします。
Claude Code では、Opus 5.5 と Sonnet 5.5 の既定の effort はどちらも medium です8 high)とは違うので注意してください4
/ のように打つと、その場で effort を変えられます。/ だけならスライダーが開きますultrathink をプロンプトに入れると、その 1 回だけ深く考えさせられます。セッションの effort は変わりません8 / にすると、プランモードでは Opus、実行では Sonnet に自動で切り替わります8 / で Opus 5.5 の Fast mode を切り替えられます。サブスクリプションでは利用枠の外で、使用クレジットから払います7
Anthropic のドキュメントは、Opus 5.5 は medium で Opus 5 の high と同等以上になるとしています。Opus 5 から移るときは、前の effort を持ち込まず medium から始めるよう勧めています8
サブエージェントだけ安いモデルにする方法もあります。環境変数 CLAUDE_CODE_SUBAGENT_MODEL か、サブエージェントの定義ファイルの model で指定します8 Claude Code のサブエージェントの作り方と使い分け で詳しく説明しています。
API では、依頼ごとに model を変え、output_config.effort で考える量を決めます 4
import anthropic
client = anthropic.Anthropic()
def ask (prompt: str , hard: bool = False ) -> str :
model = "claude-opus-5-5" if hard else "claude-sonnet-5-5"
res = client.messages.create(
model=model,
max_tokens=16000 ,
output_config={"effort" : "medium" },
messages=[{"role" : "user" , "content" : prompt}],
)
return "" .join(b.text for b in res.content if b.type == "text" )
このコードは anthropic Python SDK 1.11.0 で、ダミーのキーを使ってリクエストの組み立てまで確かめました(認証エラーで止まるところまで)。max_tokens は思考と返答の合計の上限です4
Opus 5 や Sonnet 5 から移るときは、エラーになる変更があります。
変更点 Opus 5.5 Sonnet 5.5 thinking: {"type": "disabled"}400 エラー(思考は常にオン)9 使えない。代わりに between_tools で事前の思考を止める10 tool_choice の any / tool(ツール使用の強制)400 エラー9 400 エラー10 temperature などを既定以外にする— 400 エラー10 既定の effort medium4 high4
ツールを必ず呼ばせたいときは、tool_choice を auto のままにします。そのうえで strict tool use を使うか、どの場面でツールを使うかをプロンプトに書きます9
使い分けは「迷ったら Sonnet 5.5、判断と持久力が要るなら Opus 5.5、それでも足りなければ Fable 5.1 」です。
Sonnet 5.5 を起点に、判断や長時間の作業が要るなら Opus 5.5、effort を上げても足りなければ Fable 5.1 へ進む使い分けの図 図: 筆者作成。料金は Claude Platform Docs による
仕事 選ぶモデル 理由 範囲がはっきりした機能追加・バグ修正 Sonnet 5.5 Anthropic が得意分野として挙げている3 ドキュメント・スライド・表の作成 Sonnet 5.5 同上3 チャットなど待ち時間が大事な用途 Sonnet 5.5(low〜medium) 速さが Fast と分類されている1 4 数時間かかる移行・大きなリファクタリング Opus 5.5 長時間のエージェント作業向けと明記1 設計判断・曖昧な要件の整理・調査 Opus 5.5 判断の続く仕事で強いと発表3 大量の一括処理(急がない) Sonnet 5.5 + Batch API 入出力とも半額6
Claude Code では、既定の Opus 5.5 のまま始めて構いません。Sonnet 5.5 で済む作業が多いと分かったら、/ に切り替えて既定を変えます。GitHub Actions で PR レビューを回すなど、回数が多い自動実行では Sonnet 5.5 が費用面で有利です。設定方法は Claude Code を GitHub Actions で動かして PR レビューを自動化 を参照してください。
モデルが見つからないエラーになる : Claude Code が古い可能性があります。Opus 5.5 には v2.1.280 以降、Sonnet 5.5 には v2.1.284 以降が必要です8 sonnet が Sonnet 5.5 にならないclaude-sonnet-5-5 か ANTHROPIC_DEFAULT_SONNET_MODEL で指定してください8 Opus 5.5 にすると返事が遅い : 既定の medium のまま、作業内容に合わせて / を試します。急ぐときは /(使用クレジット払い)も選べます7 トークン数が想定より多い : Claude 4.7 以降のモデルは新しいトークナイザーで、同じ文章でも約 30% 多くのトークンになります6 サイバーセキュリティの依頼が別モデルで答えられる : Sonnet 5.5 では、危険度の高いセキュリティ作業は Sonnet 5 にフォールバックします3
LLM の費用をまとめて監視したい場合は、Workers AI と AI Gateway で LLM の費用を管理する も参考になります。OpenAI の Codex CLI と比べたい人は Codex CLI と Claude Code の比較 を読んでください。
Opus 5.5(2026-09-22)は $4 / $20、Sonnet 5.5(2026-09-28)は $2 / $10。文脈 1M トークン・最大出力 128K は同じ
日常の実装とバグ修正は Sonnet 5.5、長時間のエージェント作業と設計判断は Opus 5.5、さらに上は Fable 5.1
Claude Code では / で変更する。Enter で既定に保存、s でこのセッションだけ
Claude Code での既定の effort は両方とも medium。API の Sonnet 5.5 は high
費用はキャッシュで約半分になる。単価だけでなく、自分の作業で 1 タスクあたりの費用を測る
次にやることは、手元の Claude Code を claude update で更新し、同じ作業を / と / で 1 回ずつ試すことです。
100 万トークンあたり、Opus 5.5 は入力 $4・出力 $20、Sonnet 5.5 は入力 $2・出力 $10 です6
セッション中に / を実行し、ピッカーで選びます8 s でこのセッションだけ切り替えます。起動時に claude --model sonnet と指定する方法や、settings.json に "model": "sonnet" と書く方法もあります。
Anthropic の発表では、Terminal-Bench 4.0・FrontierCode・GDPval-AA で Opus 5.5 が GPT-6 Astra を上回っています。一方、AutomationBench と Terminal-Bench-Science 0.1 では GPT-6 Astra が上です2
1M トークンです1 [1m] の指定も追加料金も要りません。既定では約 967K トークンで自動圧縮されます8
できません。Opus 5.5 の思考は常にオンで、thinking: {"type": "disabled"} を送ると 400 エラーになります9 thinking: {"type": "between_tools"} で事前の思考を止められます10
公式ドキュメントは、まず Opus 5.5 を使い、effort を上げても評価が足りないときに Fable 5.1 を使うよう勧めています1 6