AI コードレビューにチームのルールを載せるには、まず過去の PR のレビューコメントから口伝(書かれていないルール)を棚卸しします。次にそれを「ID・守ること・理由・例」の形で 10〜20 個書きます。置き場所は、GitHub Copilot なら .github/copilot-instructions.md と *.instructions.md、Claude Code なら CLAUDE.md と REVIEW.md です。この記事では、手元のリポジトリで Claude Code の /code-review を 11 回動かした結果をもとに、ルールの書き方・数・分け方・効果の測り方を手順にまとめます。仕様は 2026 年 10 月 9 日時点の公式ドキュメントで確かめました。
AI コードレビューにチームのルールを載せるとは、レビュアーの頭の中にある判断基準を、AI が毎回読むファイルに書き出すことです。AI レビュアーは、テナントの絞り忘れや個人情報のログ出力のような一般的なバグなら、ルールがなくても見つけます。一方で「現在時刻は now() から取る」「エラーは AppError で投げる」のようなチーム固有の約束は、書かなければ毎回は守られません。
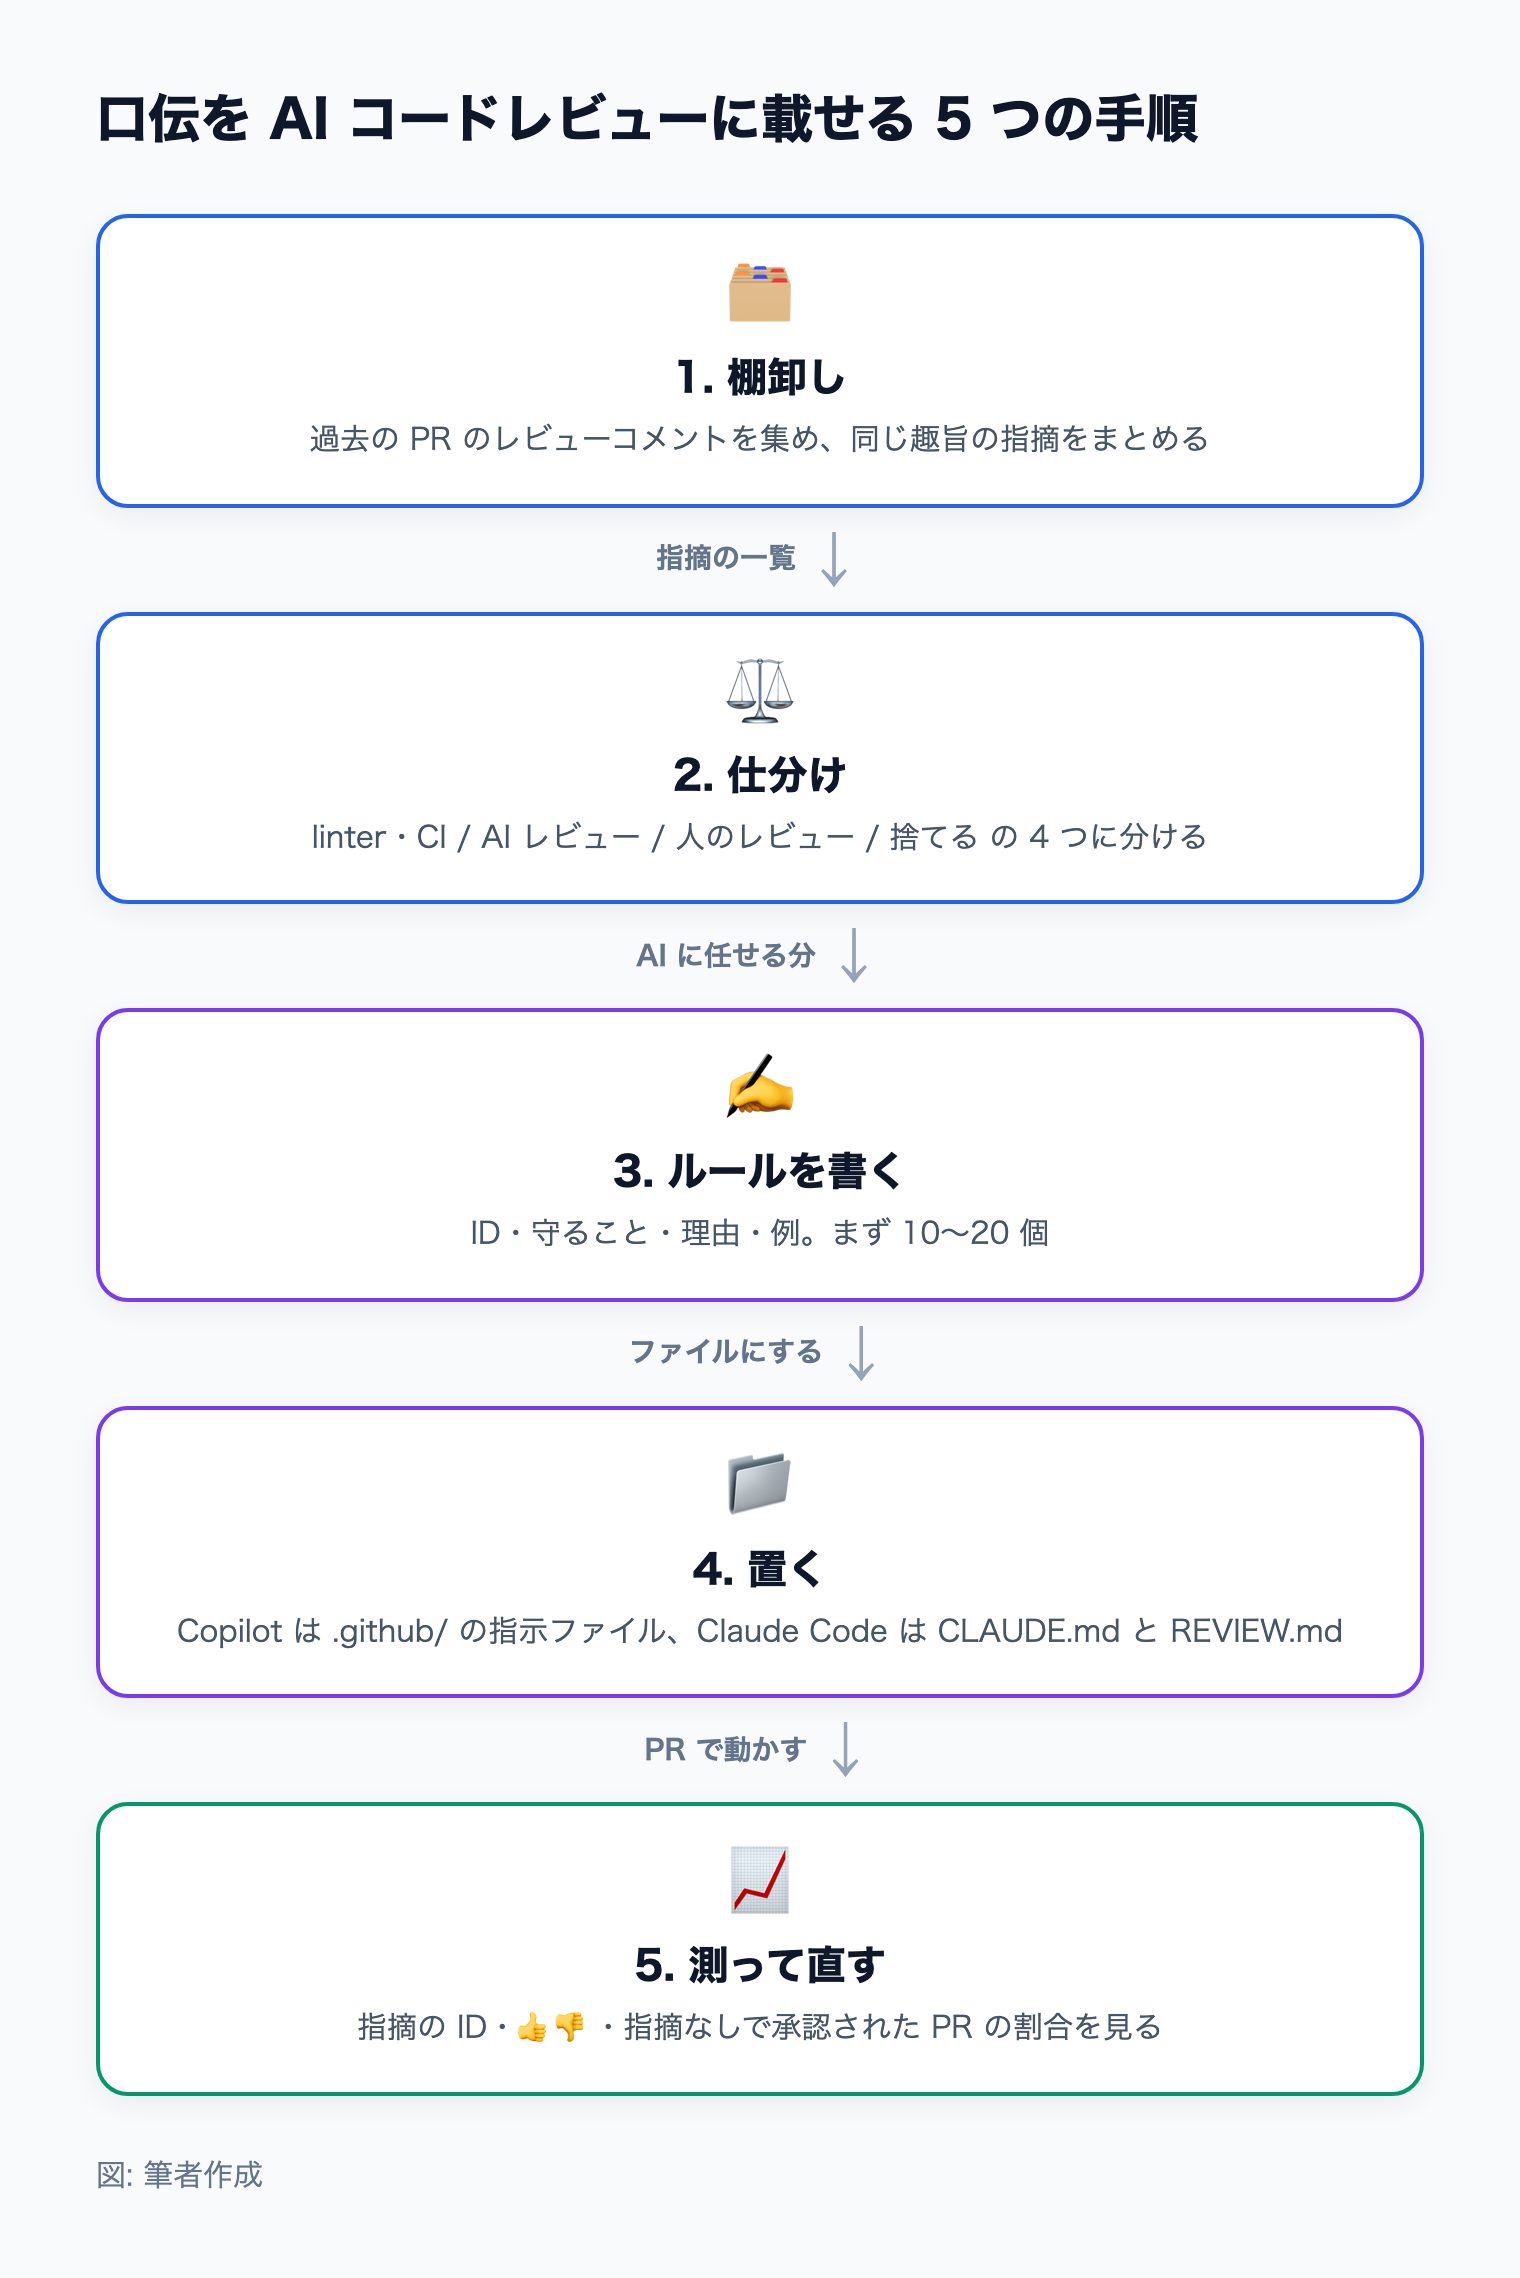 口伝を AI コードレビューに載せる 5 つの手順。棚卸し、仕分け、ルールを書く、置く、測って直す図: 筆者作成
流れは 5 段です。「棚卸し」と「仕分け」は人が判断し、ファイルに書いたあとは PR ごとに AI が同じ基準で見ます。最後に指摘を数えて、ルールを直します。
ルールの効き方は AI ごとに違います。GitHub Copilot のコードレビュー(Copilot code review)は、指示ファイルを「レビューの指針」として読みます1。Claude Code の GitHub App 版レビュー(Code Review)は、CLAUDE.md の違反を軽い指摘(Nit)として扱い、REVIEW.md をレビュー専用の指示として扱います2。
AI にコードを書かせる人が増え、レビューする側が先に詰まり始めたからです。Qiita では、ストック 5 以上の記事に付いたタグの数が、直近 14 日で前の 14 日より伸びています。copilot は 2.0 倍、GitHubCopilot は 1.67 倍、AI駆動開発 は 1.33 倍でした3。
Qiita のタグ別記事数(ストック 5 以上):直近 14 日と前の 14 日データを表で見る
Qiita のタグ別記事数(ストック 5 以上):直近 14 日と前の 14 日| タグ | 前の 14 日(件) | 直近 14 日(件) |
|---|
| copilot | 1 | 3 |
|---|
| GitHubCopilot | 2 | 4 |
|---|
| AI駆動開発 | 5 | 7 |
|---|
| ClaudeCode | 14 | 14 |
|---|
Zenn でも、e-dash の「レビューの口伝を40ルールに棚卸ししてAIレビューに載せた」(2026-10-07)が読まれています。半年分の PR に付いた 1,105 件のインラインコメントを 40 のルールにまとめ、AI レビューに載せた事例です。記事は出発点を「口伝を明文化して、その置き場所をレビュー AI にする。」と書いています4。
道具の側も、ルールを受け取る形がそろってきました。Copilot code review は .github/copilot-instructions.md に加えて、CLAUDE.md・GEMINI.md・REVIEW.md も読みます1。Claude Code の Code Review も REVIEW.md を読むので、1 つのファイルを両方の AI に読ませられます2。
棚卸しの材料は、過去の PR に付いたレビューコメントです。GitHub CLI(gh)で、リポジトリの PR レビューコメントを JSON Lines に書き出せます。次のコマンドは gh 2.98.0 で動かしました。発言者は出力しません。誰の指摘かではなく、ルールの中身を議論するためです。
gh api --paginate "repos/OWNER/REPO/pulls/comments?per_page=100&sort=created&direction=desc" \
--jq '.[] | select(.created_at >= "2026-04-01") | {pr: (.pull_request_url | split("/") | last), path, body}' \
> review-comments.jsonl
wc -l review-comments.jsonl
公開リポジトリの anthropics/claude-code-action で試すと、30 秒ほどで 174 件が取れました。この 174 件を Claude Code に読ませ、同じ趣旨の指摘をまとめてもらいます。
claude -p "review-comments.jsonl は PR のレビューコメント(1 行 1 件)です。同じ趣旨の指摘をまとめて、ルールの候補を件数の多い順に最大 10 個、表で出してください。列は「候補」「件数」「置き場所」。置き場所は linter/CI・AIレビュー・人のレビュー・捨てる のどれか。ファイルは編集しないこと。" \
  --model sonnet --allowedTools Read Bash
実際の出力から、一部を抜粋します(Claude Code 2.1.295、2026-10-09 実行)。
| 候補 | 件数 | 置き場所 |
|---|---|---|
| ドキュメント・コメント・PR 説明が、実装と食い違っていないか | 約22 | AIレビュー |
| 信頼境界に触れる変更(権限モード、fork の PR など)は、攻撃シナリオを人が確認する | 約22 | 人のレビュー |
| デフォルト値やフラグを変えたら、全呼び出し元と CI ジョブへの影響を確認する | 9 | AIレビュー |
| Actions と依存ライブラリをコミット SHA で固定する | 6 | linter/CI |
Claude は「件数は目視で数えた概数(±2 程度)です」と添えていました。件数は目安として扱い、採るかどうかは人が決めます。
候補は、AI レビューに載せる前に 4 つに仕分けます。e-dash の事例でも、linter や CI で機械的に担保できるものは採用していません4。
| 置き場所 | 向いている指摘 | 例 |
|---|
| linter・CI | 文字列やパターンだけで判定できる | Actions を SHA で固定、console.log の禁止 |
| AI レビュー | 文脈を読めば判定できるが、機械的には書きにくい | 新しい API に統合テストがあるか、エラーの種類が正しいか |
| 人のレビュー | 設計・仕様・リスクの判断が要る | 権限まわりの変更、データ移行の手順 |
| 捨てる | 好みの問題、今のコードに合わない | 変数をまとめるかどうか |
linter で取れるものを AI に任せると、毎回の結果が揺れます。AI に渡すのは「読めば分かるが、正規表現では書けない」ものに絞ります。
AI が守れるルールは、違反かどうかを第三者が判定できる形をしています。Claude Code の公式ドキュメントも、「コードをきちんと整形する」ではなく「インデントはスペース 2 つ」のように、確かめられる粒度で書くよう勧めています5。GitHub も、短い命令形の指示と、良い例・悪い例のコードを並べることを勧めています6。
この記事では、1 つのルールを次の 4 項目で書きます。
## [R2] API のエラーは `AppError` で投げる
- 守ること: `src/api/` では `throw new Error(...)` を使わず、`src/lib/errors.ts` の `AppError` にコードを付けて投げる
- コード: `NOT_FOUND`(404)/ `INVALID`(400。入力の誤り)/ `FORBIDDEN`(403)の 3 つだけ。ほかの値を提案しない
- 理由: ハンドラが `code` を見て HTTP ステータスに変換するため
- 例: NG `throw new Error("invoice not found")` / OK `throw new AppError("NOT_FOUND", "invoice not found")`
項目ごとの狙いは次のとおりです。
- ID: 指摘の先頭に
[R2] と付けさせると、あとで数えられる(効果の測定に使う)
- 守ること: 対象のパスと、使う関数・使わない関数を名前で書く
- 理由: AI が例外を判断するときの手がかりになる。人がルールを見直すときにも要る
- 例: NG と OK を 1 行ずつ。許される値が決まっているなら列挙する
「コード」の行は、実験で後から足しました。初版のルールには許される値を書いていませんでした。すると 3 回中 2 回、Claude が errors.ts にない BAD_REQUEST を直し方として提案しました。3 つの値を列挙して「ほかの値を提案しない」と書いたあとの 5 回は、すべて正しい INVALID を提案しました。
GitHub は、Copilot code review が対応していない指示の例を挙げています6。
- コメントの書式を変える、絵文字を付ける
- PR の概要コメントに要約やチェックリストを足す
- 「指摘がすべて解決するまでマージさせない」のように、本来の機能を変える
- 「https://example.com/standards の規約でレビューして」のように外部リンクを読ませる(中身を指示ファイルに書き写す)
- 「もっと正確に」「漏れなく」のような曖昧な品質の要求
マージを止めたいなら、指示ではなくブランチ保護や CI の仕事です。曖昧な要求は、具体的なルールに言い換えます。
Copilot code review は、リポジトリの指示ファイルを PR の head ブランチ(変更を入れたブランチ)から読みます1。そのため、指示ファイルの変更は、同じ PR の中でマージ前に試せます。
| ファイル | 置き場所 | 効く範囲 |
|---|
| リポジトリ全体の指示 | .github/copilot-instructions.md | すべてのレビュー |
| パスごとの指示 | .github/instructions/**/*.instructions.md | applyTo の glob に合うファイルが変更されたとき |
| エージェント共通の指示 | ルートの AGENTS.md | ほかの AI ツールと共有するルール |
| ほかに読むファイル | CLAUDE.md・GEMINI.md・REVIEW.md | ある場合だけ読む |
出典: GitHub Docs178(2026-10-09 参照)
パスごとの指示は、ファイル名を .instructions.md で終え、先頭の frontmatter に applyTo を書きます。複数の glob はカンマで区切ります。excludeAgent: "code-review" を書くと、そのファイルはコードレビューに使われず、Copilot cloud agent だけが読みます7。
---
applyTo: "src/api/**/*.ts"
---
# API のレビュールール

## [R2] API のエラーは `AppError` で投げる
- 守ること: `throw new Error(...)` を使わず、`src/lib/errors.ts` の `AppError` にコードを付けて投げる
- コード: `NOT_FOUND` / `INVALID` / `FORBIDDEN` の 3 つだけ
- 例: NG `throw new Error("invoice not found")` / OK `throw new AppError("NOT_FOUND", "invoice not found")`
リポジトリ全体の .github/copilot-instructions.md には、Copilot だけに伝えたいことを短く書きます。
コードレビューの指摘は日本語で書く。
ルールに違反する指摘には、REVIEW.md のルール ID(例: [R2])を先頭に付ける。
GitHub のチュートリアルは、1 ファイルを約 1,000 行までに抑え、まず 10〜20 個の具体的な指示から始めるよう勧めています。長いファイルでは、一部の指示が見落とされることがあるからです6。2026 年 10 月 9 日に読んだ範囲の公式ドキュメントには、コードレビューが読む文字数の上限は書かれていませんでした。
全員の PR に自動でレビューを付けるには、リポジトリの Settings の「Rulesets」でブランチのルールセットを作り、「Automatically request Copilot code review」を選びます。push のたびにレビューする「Review new pushes」と、ドラフトもレビューする「Review draft pull requests」も選べます9。設定の詳しい流れは「GitHub Copilot のコーディングエージェントをチーム開発に組み込む」にまとめています。
指示が効かないときは、Settings → Copilot → Code review の「Use custom instructions when reviewing pull requests」がオンになっているかを確かめます7。
Claude Code には、レビューの入り口が 3 つあります。読むファイルが入り口ごとに違うので、先に整理します。
| 入り口 | 動く場所 | 読むルール | 条件(2026 年 10 月時点) |
|---|
/code-review(別名 /review) | 手元の Claude Code | CLAUDE.md(REVIEW.md は読まない) | どのプランでも使える |
| Code Review | Anthropic 側(GitHub App) | CLAUDE.md(違反は Nit)と REVIEW.md | Team・Enterprise、リサーチプレビュー |
| Claude Code GitHub Actions | 自分の GitHub Actions | CLAUDE.md | Claude API キーなど |
出典: Claude Code Docs21011(2026-10-09 参照)
/code-review は、ブランチの差分を正しさの観点でレビューする、Claude Code 同梱のスキルです。/review はその別名で、--fix で直し、--comment で PR にコメントを付けます10。このレビューは通常の Claude Code と同じく CLAUDE.md に従いますが、REVIEW.md は読みません2。
そこで、ルールの正本を REVIEW.md に書き、CLAUDE.md から @REVIEW.md で取り込みます。@パス の取り込みは、起動時に CLAUDE.md と一緒に読み込まれます5。
# billing-api

請求と返金の API(TypeScript)。テストは `npm test`。

- レビューの指摘は日本語で書く
- レビューのルール: @REVIEW.md
この構成で、ルール違反を 5 つ仕込んだブランチをレビューさせました。違反は、テナントの絞り忘れ(R3)、throw new Error 2 か所(R2)、new Date() の直接呼び出し(R1)、ログへのメールアドレス出力(R4)、統合テストなし(R5)です。
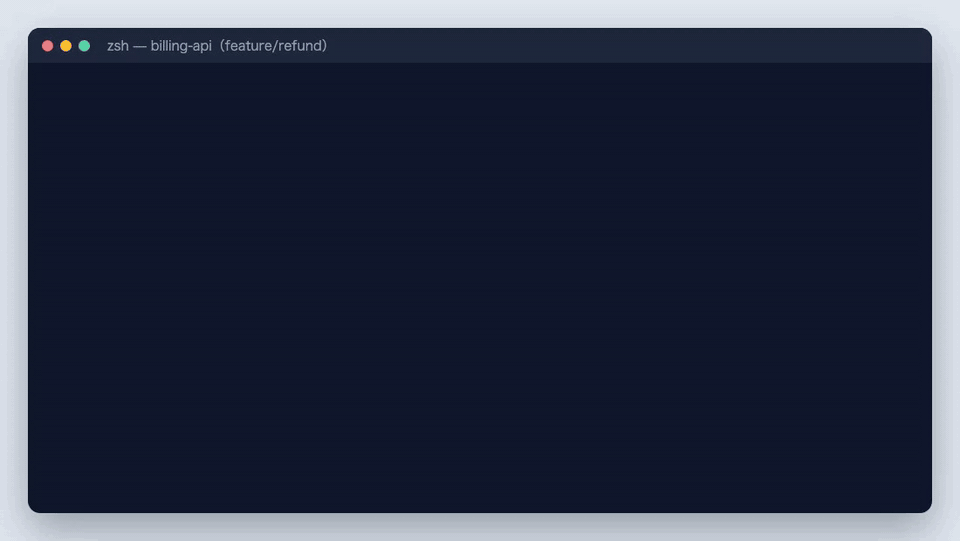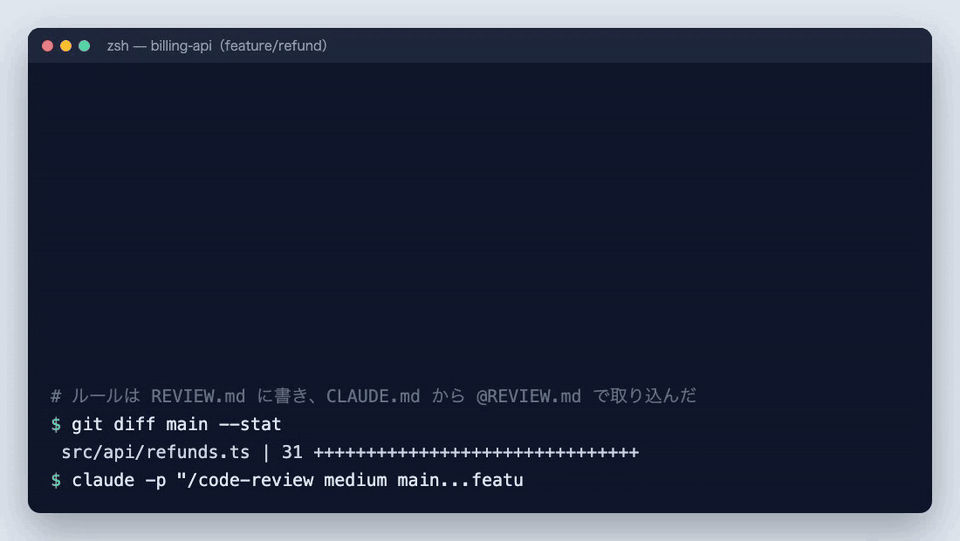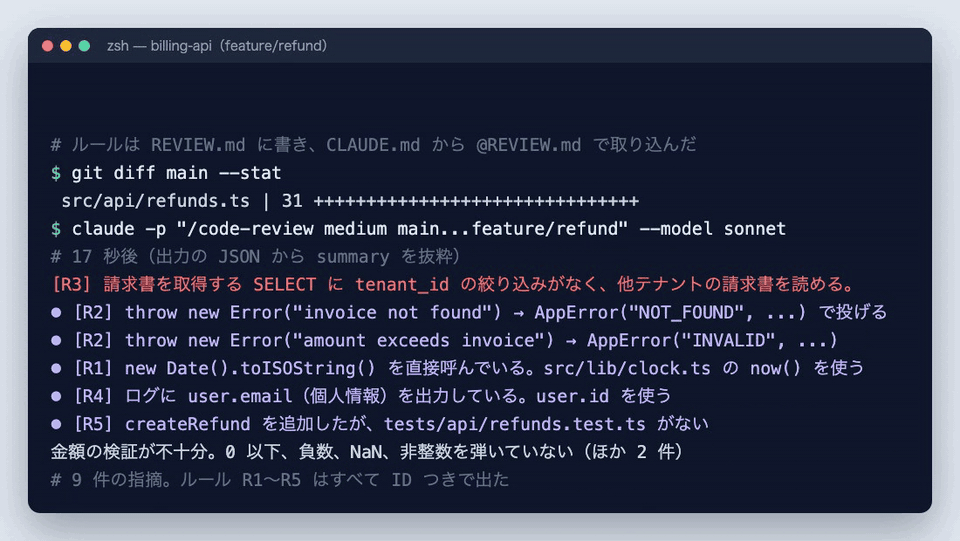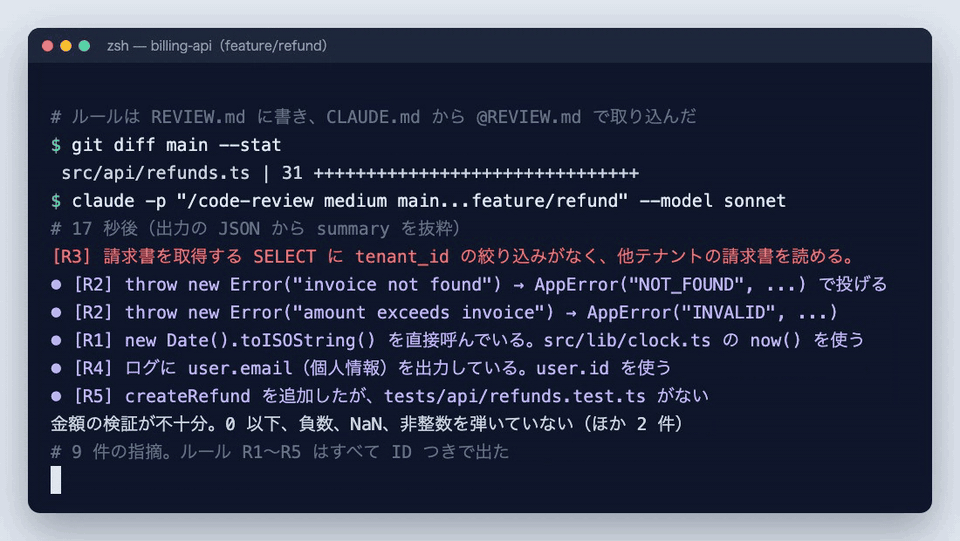 claude -p で /code-review を実行し、R1〜R5 の違反が ID つきで指摘される様子Claude Code 2.1.295・Sonnet で実行(2026-10-09)。実際は --setting-sources project --output-format json も付け、JSON の summary を要約して抜粋
claude -p "/code-review medium main...feature/refund" --model sonnet \
  --setting-sources project --output-format json
出力は JSON の配列で返り、1 件ごとに file・line・summary・failure_scenario が入ります。R1 の指摘は次のとおりです。
{
  "file": "src/api/refunds.ts",
  "line": 24,
  "summary": "[R1] `new Date().toISOString()` を直接呼んでいる。`now()` を使うこと。",
  "failure_scenario": "テストで `fixNow()` を使っても createdAt が固定されない。返金の作成時刻を検証するテストが不安定になる。"
}
--setting-sources project は、自分の ~/.claude/CLAUDE.md を混ぜずに、リポジトリのルールだけで試すために付けました。1 回あたりの費用は CLI の表示で 0.03〜0.08 ドル、時間は 16〜29 秒でした。
Claude Code の Code Review は、PR ごとに複数のエージェントが並列で差分を調べ、検証を通った指摘だけを行ごとのコメントで投稿します。指摘は 🔴 Important・🟡 Nit・🟣 Pre-existing の 3 段階です。PR を承認もブロックもしません2。
REVIEW.md には、ルールのほかに指摘の重さと量を書けます。公式ドキュメントは、次の調整が効きやすいとしています2。
- 重さ: このリポジトリで Important とする指摘を言い切る(例: データ漏えい・後方互換のないマイグレーション)
- Nit の上限: 「Nit は 5 件まで。残りは件数だけ要約に書く」
- 見ないもの: 生成コード・ロックファイル・CI がすでに見ているもの
- 再レビュー: 「2 回目以降は新しい Nit を出さず、Important だけ」
CLAUDE.md のルールに反する変更は、既定では Nit になります。REVIEW.md で「CLAUDE.md の違反は Important」と上げることもできます2。
費用は 1 回の平均が 15〜25 ドルで、プランの利用枠とは別に請求されます(2026 年 10 月時点)2。push のたびにレビューする設定では回数分かかるので、まず「PR 作成時に 1 回」から始めます。
Claude Code GitHub Actions でも、Claude はリポジトリの CLAUDE.md に従います。公式の例は、code-review プラグインのスキルを --comment 付きで PR ごとに動かす workflow です11。workflow の書き方と権限は「Claude Code GitHub Actions で PR レビューを自動化」で解説しています。
チェックリストをスキルにする場合は、名前に注意します。プロジェクトに code-review という名前のスキルを置くと、同梱の /code-review が置き換わります。しかも別名の /review は、そのスキルを実行しません12。team-review のように別の名前にします。スキルの作り方は「Claude Code スキルの作り方」にまとめています。
両方の AI を使うチームでは、REVIEW.md をレビュールールの正本にするのが手間が少ない置き方です。Copilot code review と Claude Code の Code Review は REVIEW.md を直接読みます。手元の /code-review には CLAUDE.md の @REVIEW.md で届けます。
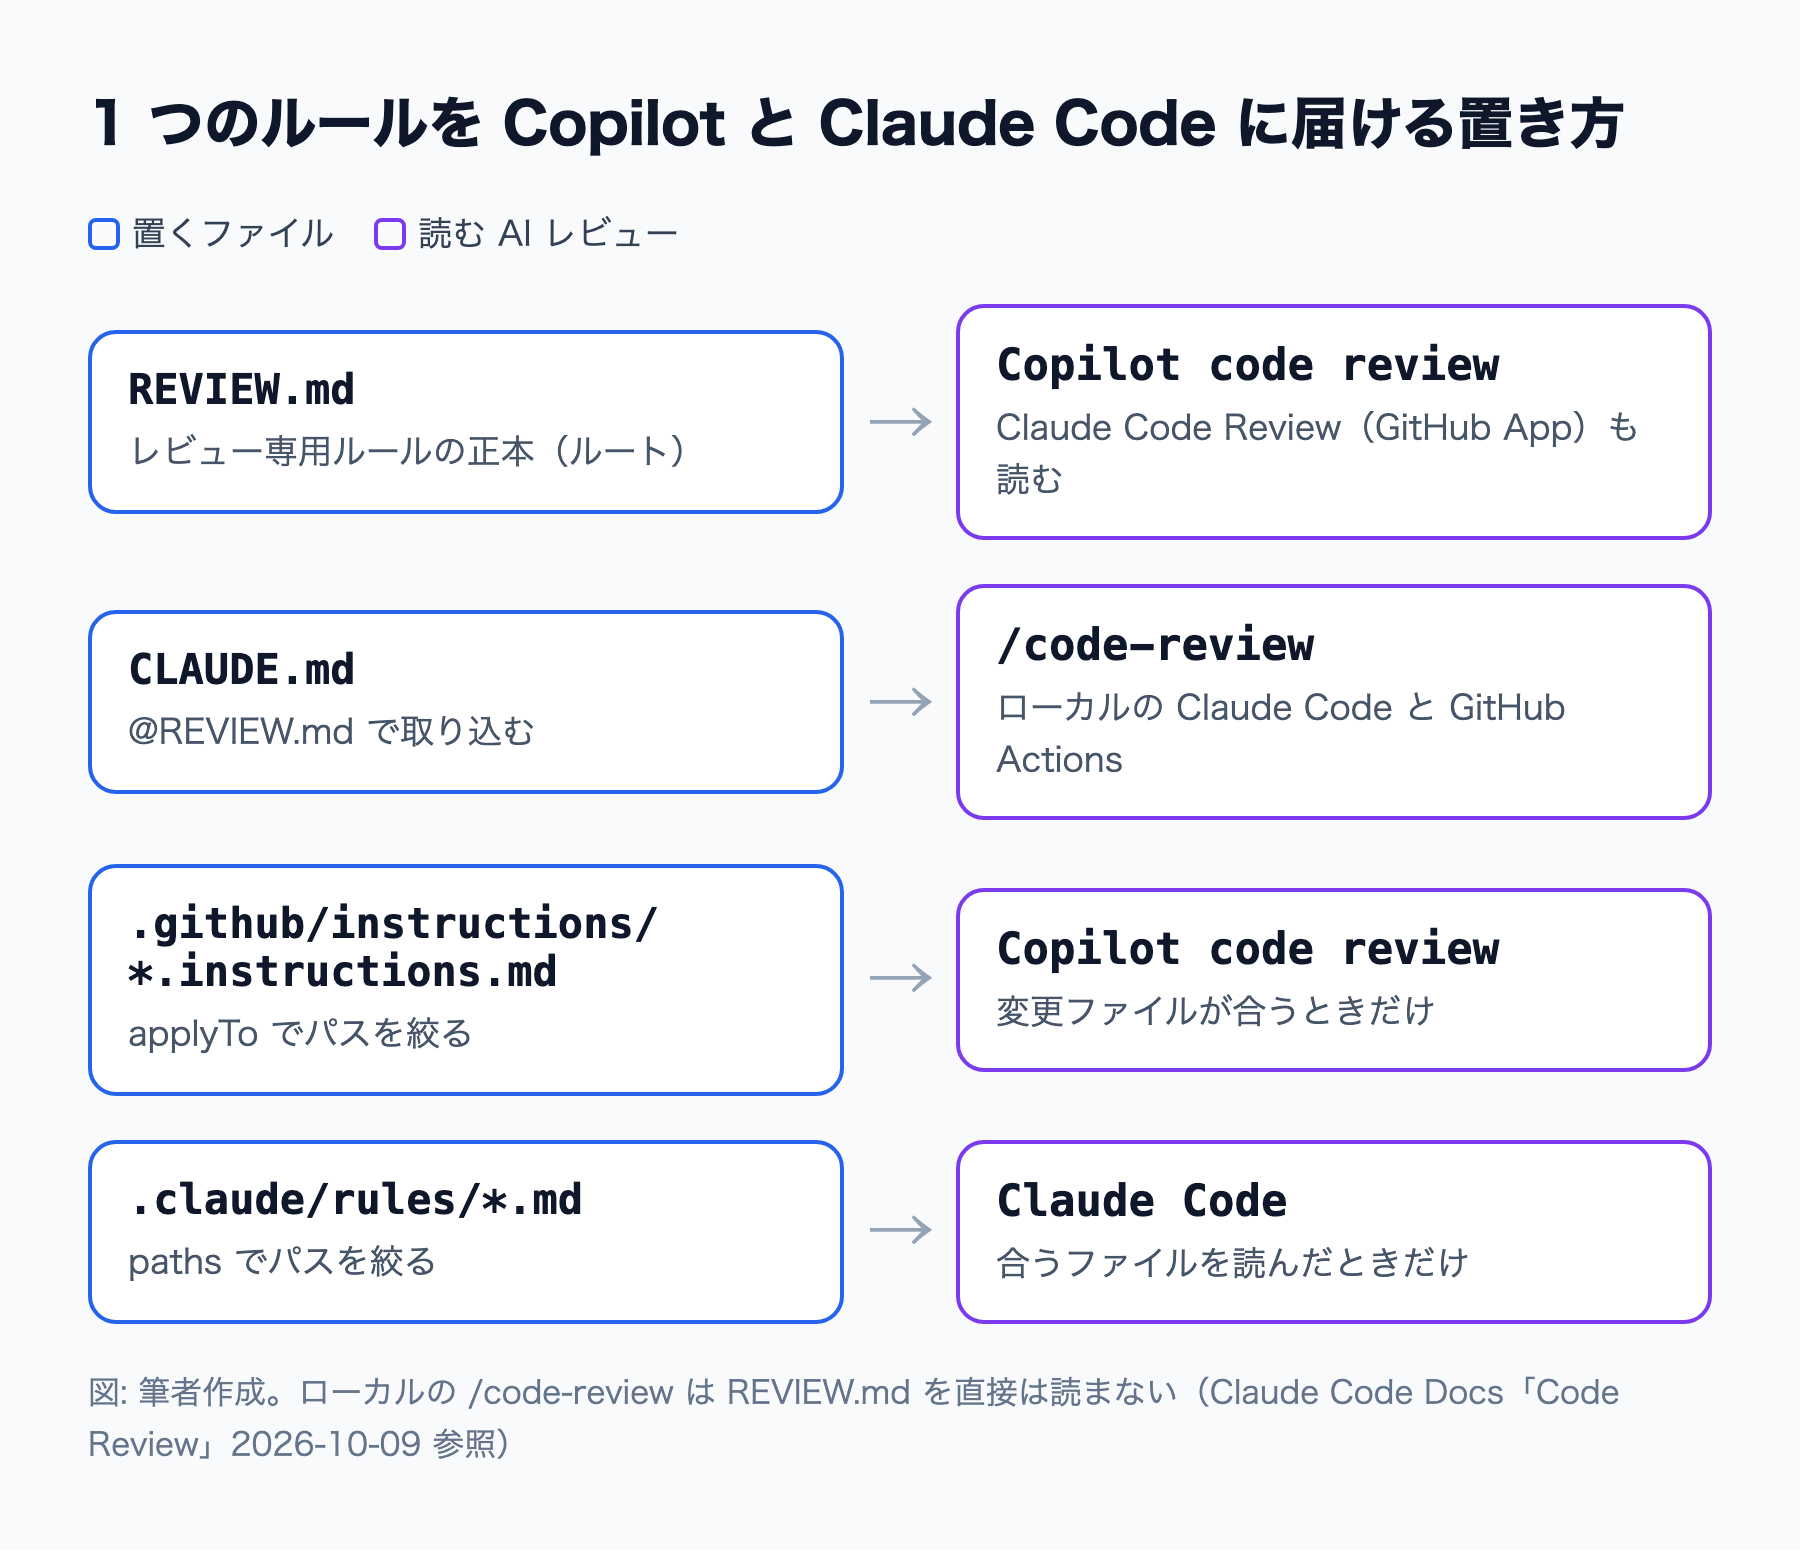 REVIEW.md・CLAUDE.md・パスごとの指示ファイルが、それぞれどの AI レビューに読まれるかの対応図図: 筆者作成。出典: GitHub Docs、Claude Code Docs(2026-10-09 参照)
.
├── REVIEW.md                       # レビュールールの正本(R1〜R20 程度)
├── CLAUDE.md                       # プロジェクトの説明 + @REVIEW.md
├── .github/
│   ├── copilot-instructions.md     # Copilot だけに伝えること(言語・ID の付け方)
│   └── instructions/
│       └── api.instructions.md     # applyTo: "src/api/**/*.ts"
└── .claude/
    └── rules/
        └── api.md                  # paths: ["src/api/**/*.ts"]
CLAUDE.md 自体の書き方と AGENTS.md との使い分けは、「CLAUDE.md の書き方:AGENTS.md との違いと併用方法」で扱っています。
ルールは 10〜20 個から始め、指摘の結果を見て足します。目安は次のとおりです。
- 全体のルール: GitHub は 10〜20 個の具体的な指示から始めるよう勧めている6。Claude Code は 1 つの
CLAUDE.md を 200 行未満に抑えるよう勧めている。取り込んだファイルも起動時に読まれるので、@REVIEW.md の行数も含めて考える5
- パスごとのルール: 一部のディレクトリにだけ効くルールは、Copilot は
applyTo、Claude Code は .claude/rules/ の paths に分ける。合うファイルを扱うときだけ読まれるので、全体のファイルが膨らまない75
- 矛盾を消す: 2 つの指示が食い違うと、Claude はどちらかを選んでしまう5。Claude Code 2.1.283 以降なら
/doctor prompt-audit で、古い指示や矛盾を洗い出せる5
e-dash の事例では、ルールが増えるにつれて AI が差分と関係のないコードまで読み始めました。そこで、ルールごとに「合図になる文字列」を決めて、差分にそれが出たときだけ該当ルールを開く形に変えています4。ルールが数十個に増えたら、この分け方も参考になります。
ルールの効果は「指摘が増えたか」ではなく、「決めたルールが毎回、同じ形で指摘されるか」で測ります。筆者は、5 つの違反を仕込んだ同じブランチを、ルールの有無を変えて /code-review medium で計 11 回レビューさせました。
/code-review の結果:5 つのルール違反をすべて指摘した回数と、存在しないエラーコードを提案した回数データを表で見る
/code-review の結果:5 つのルール違反をすべて指摘した回数と、存在しないエラーコードを提案した回数| 条件 | 5 つの違反をすべて指摘した回数(回) | 存在しないコードを提案した回数(回) |
|---|
| ルールなし(3 回) | 2 | 0 |
|---|
| ルールあり・初版(3 回) | 3 | 2 |
|---|
| ルールあり・コードを列挙(5 回) | 5 | 0 |
|---|
分かったことは 4 つです。
- ルールがなくても、Claude はコードから約束を推測する: ルールなしの 3 回のうち 2 回は、
clock.ts の now() や AppError を見つけて指摘しました。ただし 1 回目は R1 と R5 を見落としました
- ルールを書くと、毎回そろう: ルールありの 8 回は、すべて 5 つの違反を指摘しました。指摘の先頭には毎回
[R1] などの ID が付きました
- 例が足りないと、もっともらしい誤りが出る: 初版では、存在しない
BAD_REQUEST を 3 回中 2 回提案しました。許される値を列挙すると 0 回になりました
- 指示は「必ず守られる設定」ではない: 「日本語で書く」と書いても、8 回中 1 回は英語で返ってきました。Claude Code のドキュメントも、
CLAUDE.md は強制される設定ではなく文脈だとしています5
ルールなし・ありとも試行は数回ずつなので、傾向を見る材料として扱ってください。レビュー 11 回と手順 1 の棚卸し 1 回、計 12 回の費用は、CLI の表示で合計約 0.83 ドルでした。
運用では、次の数字を週ごとに見ると、ルールの直しどころが分かります。
| 指標 | 取り方 | 何が分かるか |
|---|
| ルール ID ごとの指摘数 | 指摘の [R2] などを数える | 効いているルール、一度も出ないルール |
| 👍 / 👎 の数 | Copilot・Code Review とも各コメントに付けられる12 | 誤検知が多いルール |
| 自動で解決された指摘の数 | Code Review の分析画面2 | 指摘が実際に直されたか |
| 指摘なしで承認された PR の割合 | 人のレビューコメントが 0 件で approve された PR を数える | 人のレビューの負担が減ったか |
最後の指標は、e-dash の事例で使われています。導入前後で 1 PR あたりのコメント数は 1.32 のまま変わらず、指摘なしで approve された PR の割合が 64.5% から 71.2% に上がりました4。コメント数だけを見ると「効果なし」に見えるので、複数の指標で見ます。
Code Review の結果を CI で使うなら、チェックランの出力から重さ別の件数を JSON で取り出せます2。
gh api repos/OWNER/REPO/check-runs/CHECK_RUN_ID \
--jq '.output.text | split("bughunter-severity: ")[1] | split(" -->")[0] | fromjson'
AI コードレビューは、人のレビューの代わりではなく、人が見る前の一次チェックとして置きます。どちらの AI も、既定では PR を承認しません。Copilot は既定で「Comment」としてレビューを残し、必須の承認数には数えられません1。Claude Code の Code Review のチェックランは、常に neutral で終わり、マージを止めません2。
| 担当 | 見るもの |
|---|
| linter・CI | 書式、型、決まったパターンの禁止、依存関係の固定 |
| AI レビュー | REVIEW.md のルール、一般的なバグ(テナントの絞り忘れ、境界値、個人情報のログ) |
| 人のレビュー | 設計と仕様に合っているか、権限まわりの変更、AI の指摘が正しいか |
最後の「AI の指摘が正しいか」は省けません。実験でも、存在しないエラーコードを直し方として提案した回がありました。
Copilot には、条件つきで承認させる設定もあります。2026 年 10 月時点ではパブリックプレビューで、既定はオフです。変更されたファイルがすべて指定の glob に合う PR だけ、承認を数えるように絞れます(glob は 15 個まで)9。ドキュメントだけの PR など、範囲を絞って試すのが安全です。
- Copilot がルールを無視する: 指示ファイルは head ブランチから読まれます。ファイル名が
.instructions.md で終わっているか、applyTo が変更ファイルに合っているかを確かめます。設定の「Use custom instructions when reviewing pull requests」も確認します17
- ローカルの /code-review が REVIEW.md のルールを使わない: 仕様です。
CLAUDE.md に @REVIEW.md と書いて取り込みます25
- 同じ指摘が何度も出る: Copilot は再レビューで、解決済みや 👎 を付けたコメントを繰り返すことがあります1。Code Review なら
REVIEW.md に「2 回目以降は Important だけ」と書けます2
- 自作のスキルで /code-review が動かなくなった: プロジェクトのスキル名が
code-review だと、同梱のスキルを置き換えます12。名前を変えます
- 費用が読めない: Copilot code review は AI クレジットを使い、目安は 1 回あたり Lite で 0.05〜1 ドル、Balanced で 0.25〜5 ドルです。量は PR の大きさと指示ファイルに応じて増えます(2026 年 10 月時点)8。Claude Code の Code Review は平均 15〜25 ドルで、管理画面で月の上限を決められます2
- AI コードレビューにチームのルールを載せる第一歩は、過去の PR コメントの棚卸し。
gh api で書き出し、AI にまとめさせ、採るかどうかは人が決める
- ルールは「ID・守ること・理由・例」で書く。許される値は列挙する。linter で取れるものは AI に渡さない
- Copilot は
.github/copilot-instructions.md と *.instructions.md、Claude Code は CLAUDE.md と REVIEW.md。両方使うなら REVIEW.md を正本にし、CLAUDE.md から @REVIEW.md で取り込む
- 効果は、ルール ID ごとの指摘数・👍👎・指摘なしで承認された PR の割合で測る
- AI は一次チェック。設計・仕様・権限の判断と、AI の指摘が正しいかの確認は人が持つ
次にやることは、直近 3 か月の PR コメントを書き出し、最も多い指摘から 10 個のルールを REVIEW.md に書くことです。
10〜20 個から始めるのが目安です。GitHub は Copilot code review の指示を 10〜20 個の具体的な指示から始め、1 ファイルを約 1,000 行までに抑えるよう勧めています6。Claude Code は CLAUDE.md を 200 行未満に抑えるよう勧めています5。結果を見ながら足します。
2026 年 10 月 9 日に読んだ範囲の公式ドキュメントには、コードレビューが読む文字数の上限は書かれていませんでした。代わりに、1 ファイル約 1,000 行までという目安があります6。長いファイルでは一部の指示が見落とされることがあるので、短く保ちます。
CLAUDE.md はレビュー以外の作業でも読まれるプロジェクトの説明、REVIEW.md はレビューだけの指示です。Claude Code の Code Review は、CLAUDE.md の違反を Nit として扱い、REVIEW.md で重さや指摘の量まで調整できます2。ローカルの /code-review は REVIEW.md を読まないので、CLAUDE.md から取り込みます。
使えます。Copilot code review は REVIEW.md と CLAUDE.md を読み1、Claude Code の Code Review も REVIEW.md を読みます2。ルールを REVIEW.md に置けば、1 か所の修正で両方に効きます。Copilot だけに伝えたいことは .github/copilot-instructions.md に分けます。
範囲を絞るなら検討できます。Copilot の承認はパブリックプレビューで既定はオフです。承認を数えるファイルを glob で絞れます9。Claude Code の Code Review は承認もブロックもしません2。設計や権限に関わる変更は、人が承認する運用を残します。