Qwen3.8-Flash-Next は、Alibaba の Qwen チームが 2026 年 8 月 26 日に公開したオープンウェイトのモデルです1 最も小さい 1-bit 量子化でもメモリ(RAM と VRAM の合計)が 75GB 必要 です2
Qwen3.8-Flash-Next は、次の世代 Qwen4 の設計を先に試すためのプレビュー版 です。Qwen の GitHub では「Qwen3-Next が Qwen3.5 に対して果たしたのと同じ役割」と説明されています3 qwen3.8-flash です。こちらは 100 万トークンの文脈と公式の組み込みツールが付きます1
項目 値 公開日 2026-08-263 ライセンス Qwen Community License 1.01 パラメータ 総 125B(活性 6B)+ n-gram 埋め込み 51B + MTP 4B1 文脈の長さ 標準 262,144 トークン。YaRN で 100 万トークンまで拡張可1 入力 テキスト・画像・動画(ビジョンエンコーダ付き)1 思考モード enable_thinking(既定で有効)、reasoning_effort(low / medium / xhigh)1
MoE は、多数の「専門家」の中から、トークンごとに一部だけを使うしくみです。計算量は活性パラメータ(6B)に比例するので速く動きます。一方、すべての専門家の重みをメモリに載せる必要があるので、メモリは総パラメータの分だけ要ります。「速いのにメモリは大きい 」のがこのモデルの特徴です。
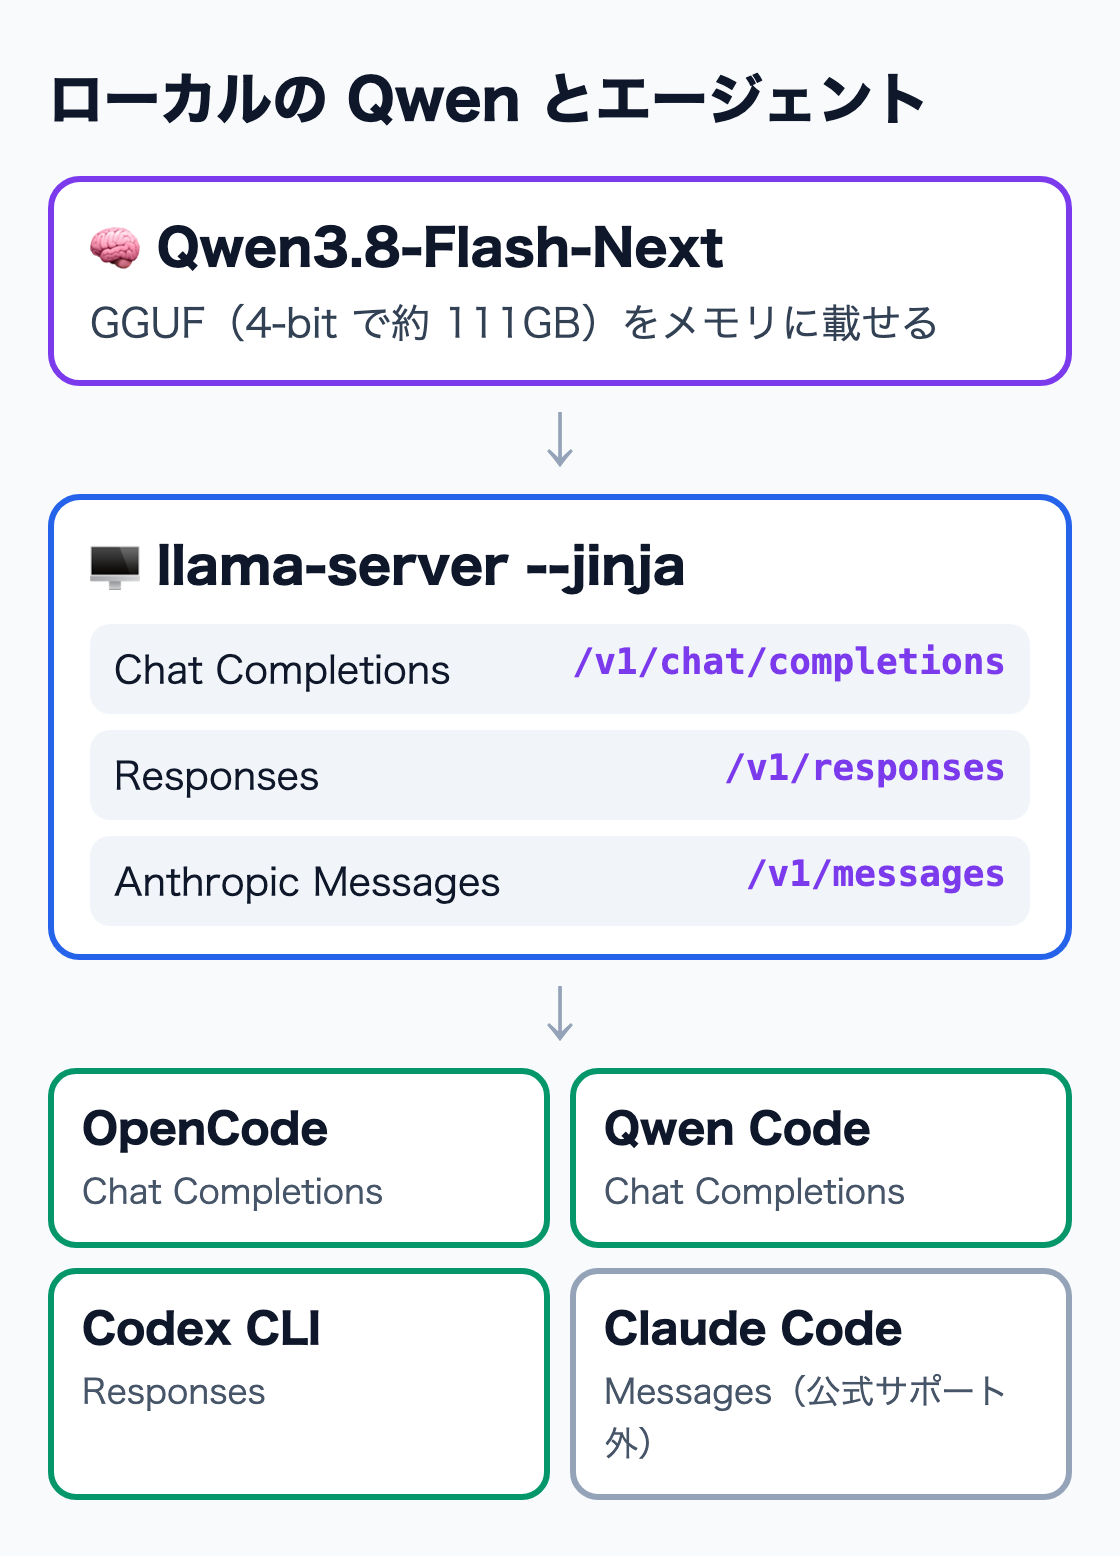
llama.cpp の llama-server が Qwen3.8-Flash-Next を読み込み、OpenAI 互換・Responses・Anthropic 互換の 3 つの API を出し、OpenCode・Qwen Code・Codex CLI がつながる構成 図: 筆者作成(各ツールの公式ドキュメントをもとに作図)
理由は、ローカルで動くモデルとして、コーディングの評価が有料の最上位モデルに並んだから です。モデルカードによると、SWE-bench Pro で 62.5 と、Claude Opus 4.6(Max)の公表値 53.4 を上回りました1
検索の関心も動いています。Google トレンド(日本・過去 90 日、2026-10-07 取得)では、「Qwen」全体の伸びは 1.02 倍とほぼ横ばいです。一方、関連キーワードでは「qwen 3.8 flash next」「qwen 3.8 flash」が「急激増加」でした4 5
Qwen・GitHub Copilot の検索関心度(日本・週ごと) データを表で見る Qwen・GitHub Copilot の検索関心度(日本・週ごと) 週 Qwen GitHub Copilot 07/08 9 11 07/15 10 7 07/22 7 7 07/29 6 7 08/05 7 5 08/12 10 5 08/19 7 7 08/26 8 7 09/02 5 6 09/09 5 6 09/16 8 3 09/23 10 4 09/30 7 6
出典: Google トレンド(日本、2026/07/08〜2026/09/30 の週、2026-10-07 取得。同じ回で比較した相対値) モデルカードに載っているコーディング系の結果を、同時期の 27B(密なモデル)と比べます1
コーディング系ベンチマーク(Qwen3.8-Flash-Next のモデルカード) データを表で見る コーディング系ベンチマーク(Qwen3.8-Flash-Next のモデルカード) ベンチマーク Qwen3.8-Flash-Next Qwen3.8-27B Claude Opus 4.6 (Max) SWE-bench Pro 62.5 61.7 53.4 SWE-bench Multilingual 81 73.8 77.5 LiveCodeBench v6 91.9 90.3 88.8
出典: Qwen3.8-Flash-Next のモデルカード(Hugging Face、2026-08)。Qwen による計測。Claude Opus 4.6 は公表値 読むときの注意が 2 つあります。
Qwen 自身の計測 です。SWE-bench Pro は、Opus 以外を Claude Code のハーネス (エージェントの実行環境)で、256K の文脈で評価しています1 比べている Claude は Opus 4.6 で、2026 年 10 月時点の最新の Claude(Opus 5.5 など)ではありません
結論は、4-bit 量子化で動かすなら 96GB 以上、最低でも 75GB です。Unsloth の公式ドキュメントは、量子化ごとの必要メモリ(RAM と VRAM の合計)を次のように示しています。最小の量子化でも「96GB の RAM かユニファイドメモリの機器が望ましい」としています2
量子化ごとの必要メモリ(RAM+VRAM の合計、GB) データを表で見る 量子化ごとの必要メモリ(RAM+VRAM の合計、GB) 量子化 必要メモリ(GB) 1-bit 75 2-bit 79 3-bit 90 4-bit(上限) 114 5-bit 163 8-bit 200 BF16 355
出典: Unsloth「Qwen3.8-Flash-Next」実行ガイド(2026-10-07 参照)。4-bit は 96〜114GB の上限値 1-bit でも 75GB と大きいのは、n-gram 埋め込みなどの一部を 4-bit 以上で残しているためです2
機材 動かせる量子化の目安 Apple Silicon の Mac(ユニファイドメモリ 128GB) 4-bit(MLX 版は約 112GB6 Apple Silicon の Mac(96GB) 1〜3-bit GPU 24GB + RAM 64GB 1〜2-bit(専門家の一部を CPU に置く) メモリ 64GB 以下の PC・Mac 本体は無理。API 版の qwen3.8-flash を使う
コミュニティ製の Strata は、よく使う専門家だけを GPU に、残りを RAM と SSD に置いて、少ない VRAM で動かすツールです5
おすすめは llama.cpp の llama-server です。1 つのサーバーで、OpenAI 互換の Chat Completions、Codex が使う Responses API、Anthropic 互換の Messages API を出せます。どのエージェントからもつなげられます。llama.cpp は v0.4.0(2026 年 9 月 4 日)からこのモデルの構造に対応しました。ただし、最適化はまだ途中だとリリースノートに書かれています7
brew install llama.cpp
llama-server --version
Hugging Face から Unsloth の GGUF を直接読み込んで起動します。-hf は「リポジトリ:量子化」の形です2
llama-server -hf unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XL \
  --jinja -c 131072 --alias qwen3.8-flash-next \
  --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.0 \
  --host 127.0.0.1 --port 8080
--jinja: モデルのチャットテンプレートを使います。OpenAI 形式のツール呼び出し(function calling)にはこれが必要です8 -c 131072: 文脈の長さです。コーディングエージェントはシステムプロンプトだけで 1 万トークンを超えることが多いので、短くしすぎないようにします--temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.0: 思考モードの推奨値です2
この起動コマンドは、各フラグの公式ドキュメントを確かめて組み立てたものです。筆者の環境ではメモリが足りず、本体での起動までは確かめていません。
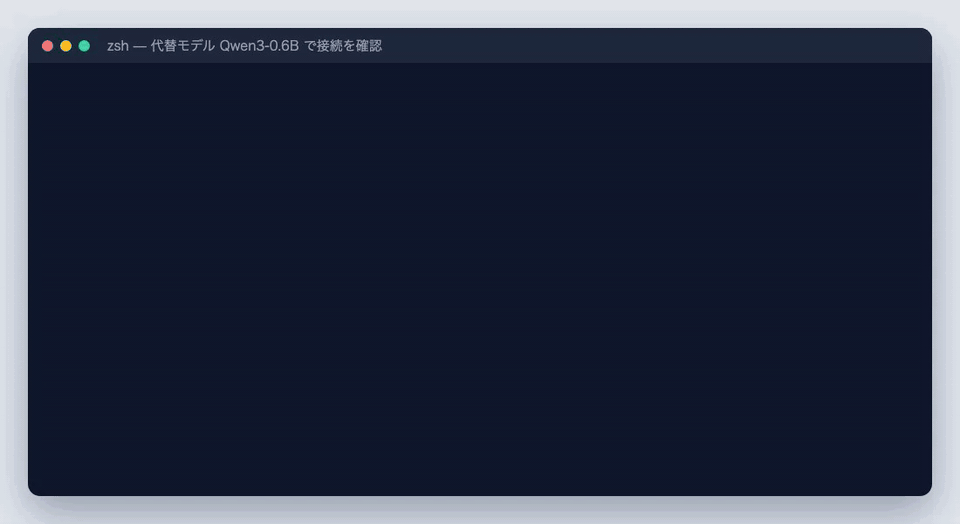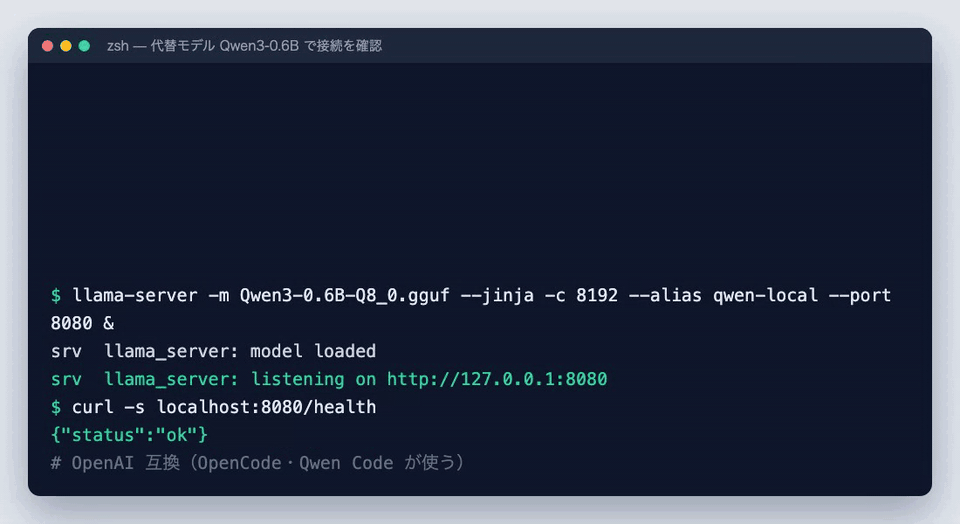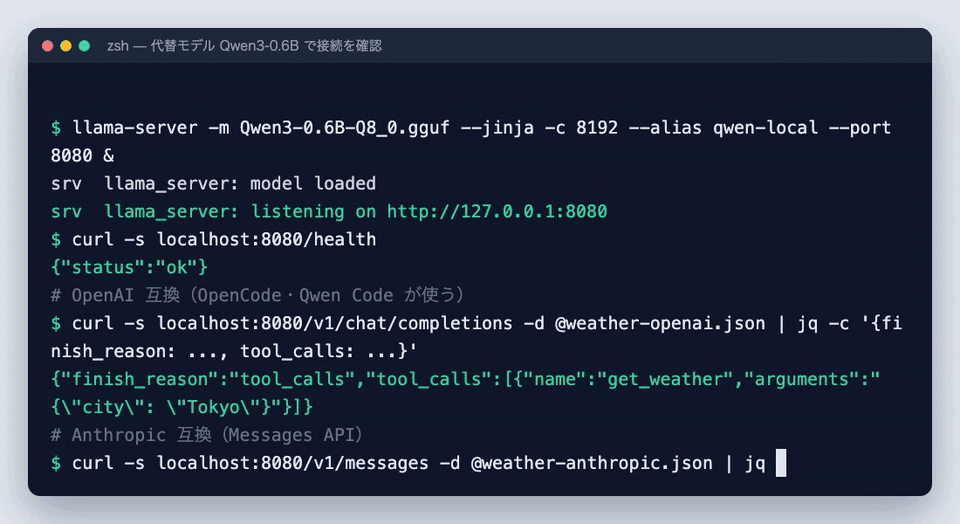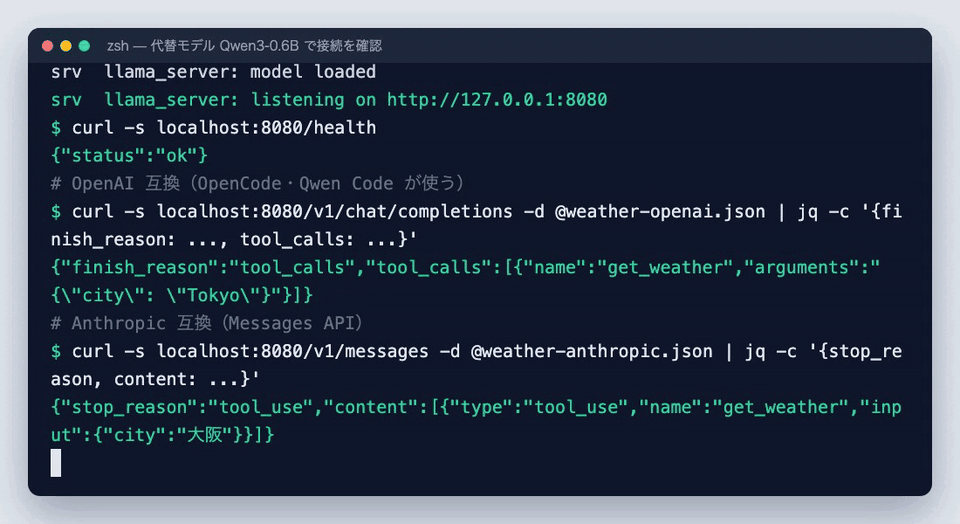
本体を落とす前に、小さなモデルで「サーバー → エージェント」の経路だけ先に確かめる と、つまずきを切り分けやすくなります。筆者は Qwen3-0.6B(約 0.6GB)で次を実行しました。
llama-server を代替の Qwen3-0.6B で起動し、OpenAI 互換と Anthropic 互換の API にツール付きのリクエストを送って、get_weather のツール呼び出しが返るまでのターミナル操作 筆者が 2026-10-07 に llama.cpp b11457(Intel Mac)で実行した出力を再現。モデルは代替の Qwen3-0.6B。リクエスト本文と jq の式は省略して表示
llama-server -m Qwen3-0.6B-Q8_0.gguf --jinja -c 8192 --alias qwen-local --port 8080
OpenAI 互換の / にツールの定義を付けて送ると、ツール呼び出しが返りました。
$ curl -s localhost:8080/v1/chat/completions -H 'Content-Type: application/json' -d '{
"model": "qwen-local",
"messages": [{"role": "user", "content": "東京の天気を調べて"}],
"tools": [{"type": "function", "function": {"name": "get_weather",
"parameters": {"type": "object", "properties": {"city": {"type": "string"}}, "required": ["city"]}}}]
}' | jq -c '{finish_reason: .choices[0].finish_reason, tool_calls: [.choices[0].message.tool_calls[]?.function]}'
{"finish_reason" :"tool_calls" ,"tool_calls" :[{"name" :"get_weather" ,"arguments" :"{\"city\": \"Tokyo\"}" }]}
Anthropic 互換の / でも、tool_use が返りました。
{ "stop_reason" : "tool_use" , "content" : [ { "type" : "tool_use" , "name" : "get_weather" , "input" : { "city" : "大阪" } } ] }
ここまで通れば、モデルを Qwen3.8-Flash-Next に差し替えるだけです。
Ollama には公式ライブラリのタグがあります9 q4_K_M は 120GB です。
ollama run qwen3.8-flash-next:125b-a6b-q4_K_M
Apple Silicon の Mac なら MLX 版も選べます。Qwen の公式 README は、対応ランタイムとして mlx-vlm を挙げています(画像入力があるため mlx-lm ではありません)3
pip install git+https://github.com/Blaizzy/mlx-vlm
mlx_vlm.generate --model mlx-community/Qwen3.8-Flash-Next-4bit --prompt "Hello" --max-tokens 256
MLX 版のモデルカードには、変換の時期によっては出力が崩れる不具合があったと注意書きがあります6
結論は、OpenCode と Qwen Code は設定ファイルだけでつながり、Codex CLI は Responses API 経由でつながる です。Claude Code は技術的にはつなげますが、Anthropic は Claude 以外のモデルでの利用をサポートしていません10
エージェント つなぐ API 設定する場所 公式のサポート OpenCode Chat Completions(/) opencode.json の providerあり(OpenAI 互換プロバイダー)11 Qwen Code Chat Completions(/) ~/あり12 Codex CLI Responses(/) ~/ の model_providersあり(独自プロバイダー)13 Claude Code Messages(/) 環境変数 ANTHROPIC_BASE_URL なし(Claude 以外は対象外)10
プロジェクトの直下に opencode.json を置きます。OpenCode の公式ドキュメントにある OpenAI 互換プロバイダーの書き方です11
{
"$schema" : "https://opencode.ai/config.json" ,
"provider" : {
"llama.cpp" : {
"npm" : "@ai-sdk/openai-compatible" ,
"name" : "llama-server (local)" ,
"options" : { "baseURL" : "http://127.0.0.1:8080/v1" } ,
"models" : {
"qwen3.8-flash-next" : {
"name" : "Qwen3.8-Flash-Next (local)" ,
"limit" : { "context" : 131072 , "output" : 65536 }
}
}
}
}
}
models のキー(qwen3.8-flash-next)は、llama-server の --alias と合わせます。OpenCode を起動して / でこのモデルを選びます。
Qwen 公式の CLI エージェント Qwen Code は、~/ に OpenAI 互換のプロバイダーを書きます12
{
"env" : { "LLAMA_API_KEY" : "not-needed" } ,
"modelProviders" : {
"openai" : [
{
"id" : "qwen3.8-flash-next" ,
"name" : "Qwen3.8-Flash-Next (llama.cpp)" ,
"envKey" : "LLAMA_API_KEY" ,
"baseUrl" : "http://127.0.0.1:8080/v1" ,
"generationConfig" : { "contextWindowSize" : 131072 , "timeout" : 300000 }
}
]
} ,
"security" : { "auth" : { "selectedType" : "openai" } } ,
"model" : { "name" : "qwen3.8-flash-next" }
}
Codex CLI の独自プロバイダーは、Responses API(wire_api = "responses")だけに対応しています13 llama-server は / を出すので、そのままつながります。
model = "qwen3.8-flash-next"
model_provider = "llamacpp"
[model_providers.llamacpp]
name = "llama.cpp"
base_url = "http://127.0.0.1:8080/v1"
env_key = "LLAMA_API_KEY"
wire_api = "responses"
export LLAMA_API_KEY=not-needed
codex
筆者が代替モデルで試したところ、llama-server がリクエストを受け取るところまでは確認できました。ただし、Codex のシステムプロンプト(約 1.5 万トークン)の読み込みが CPU だけでは遅く、応答までは確かめられませんでした。GPU やユニファイドメモリの機材で使ってください。--oss オプションで選べるのは Ollama と LM Studio だけです13
llama-server は Anthropic 互換の / を出します。llama.cpp 側は ANTHROPIC_BASE_URL=http:/ という使い方を紹介しています14 ゲートウェイ経由で Claude Code を Claude 以外のモデルにつなぐことはサポートしない と明記しています10
Qwen は自社の SWE-bench Pro の評価に Claude Code のハーネスを使っています1
ローカルで動かす利点は、コードを外に出さずに済むことと、使った分の料金がかからないこと です。一方、速さと最上位の性能はクラウドのモデルが上です。筆者は次のように分けるのが現実的だと考えます。
工程 ローカルの Qwen3.8-Flash-Next クラウドの最上位モデル 機密コードの読解・要約 ◎ 外に出さない 社内の規程しだい 定型のリファクタリング・テストの追加 ◎ 何度回しても無料 ○ 大きな設計・難しい不具合の調査 △ ◎ CI での大量の自動レビュー ○ 機材があれば ○ 料金に注意
機材が足りないときは、同じ系統の API 版 qwen3.8-flash が使えます。料金は 100 万トークンあたり入力 $0.15、出力 $0.47 で、文脈は 100 万トークンです15 baseUrl を差し替えるだけで切り替えられます。
症状 原因 対処 読み込みの途中で落ちる・極端に遅い メモリ不足でスワップしている 1 段小さい量子化にするか、--n-cpu-moe で専門家の一部を CPU に置く8 ツールを呼ばずに文章で答える --jinja が無効、または文脈が短い--jinja を付け、-c を 32K 以上にする8 11 エージェントの最初の応答まで数分かかる システムプロンプトの読み込み(プロンプト処理)が遅い GPU に載せる層を増やす。キャッシュが効く 2 回目以降は速くなる MLX で出力が崩れる 古い変換のモデル 新しい mlx-community 版と最新の mlx-vlm を使う6 codex --oss で llama.cpp を選べない--oss は Ollama と LM Studio だけconfig.toml に独自プロバイダーを書く13
Qwen3.8-Flash-Next は総 125B・活性 6B の MoE。2026 年 8 月 26 日公開、Qwen Community License 1.0
ローカルで動かすには最低 75GB、4-bit なら 96〜114GB のメモリが要る
llama-server --jinja で起動すれば、Chat Completions・Responses・Messages の 3 つの API が出るエージェントは OpenCode・Qwen Code(Chat Completions)か Codex CLI(Responses)でつなぐ。Claude Code は公式サポート外
機材が足りなければ API 版 qwen3.8-flash(入力 $0.15・出力 $0.47)で同じ設定を使い回せる
次にやることとして、まず小さなモデルで llama-server --jinja を起動し、使いたいエージェントからツール呼び出しが通るかを確かめてください。通ったら、機材に合った量子化の Qwen3.8-Flash-Next に差し替えます。
Unsloth の公式ドキュメントでは、RAM と VRAM の合計で 1-bit が 75GB、2-bit が 79GB、3-bit が 90GB、4-bit が 96〜114GB です2
Flash-Next はオープンウェイトのプレビュー版です。Flash はそれをもとにした API 版で、100 万トークンの文脈と公式の組み込みツールが付きます1
ライセンスは Qwen Community License 1.0 です1
メモリが 96GB 以上あれば Flash-Next です。SWE-bench Pro などで 27B を上回り、活性 6B なので生成も速くなります1
llama-server の Anthropic 互換 API に ANTHROPIC_BASE_URL を向ければ動かせます14 10
Apple Silicon でユニファイドメモリが 96GB 以上あれば、llama.cpp(Metal)か MLX で動かせます2 6