Cloudflare Clef は、入力(状態)と型つきの質問を渡すと、選択肢ごとの確率だけを返す「判定モデル」です。Cloudflare が 2026-10-01 に公開し、Workers AI から @cf/ と @cf/ の 2 つの名前で呼べます1 2
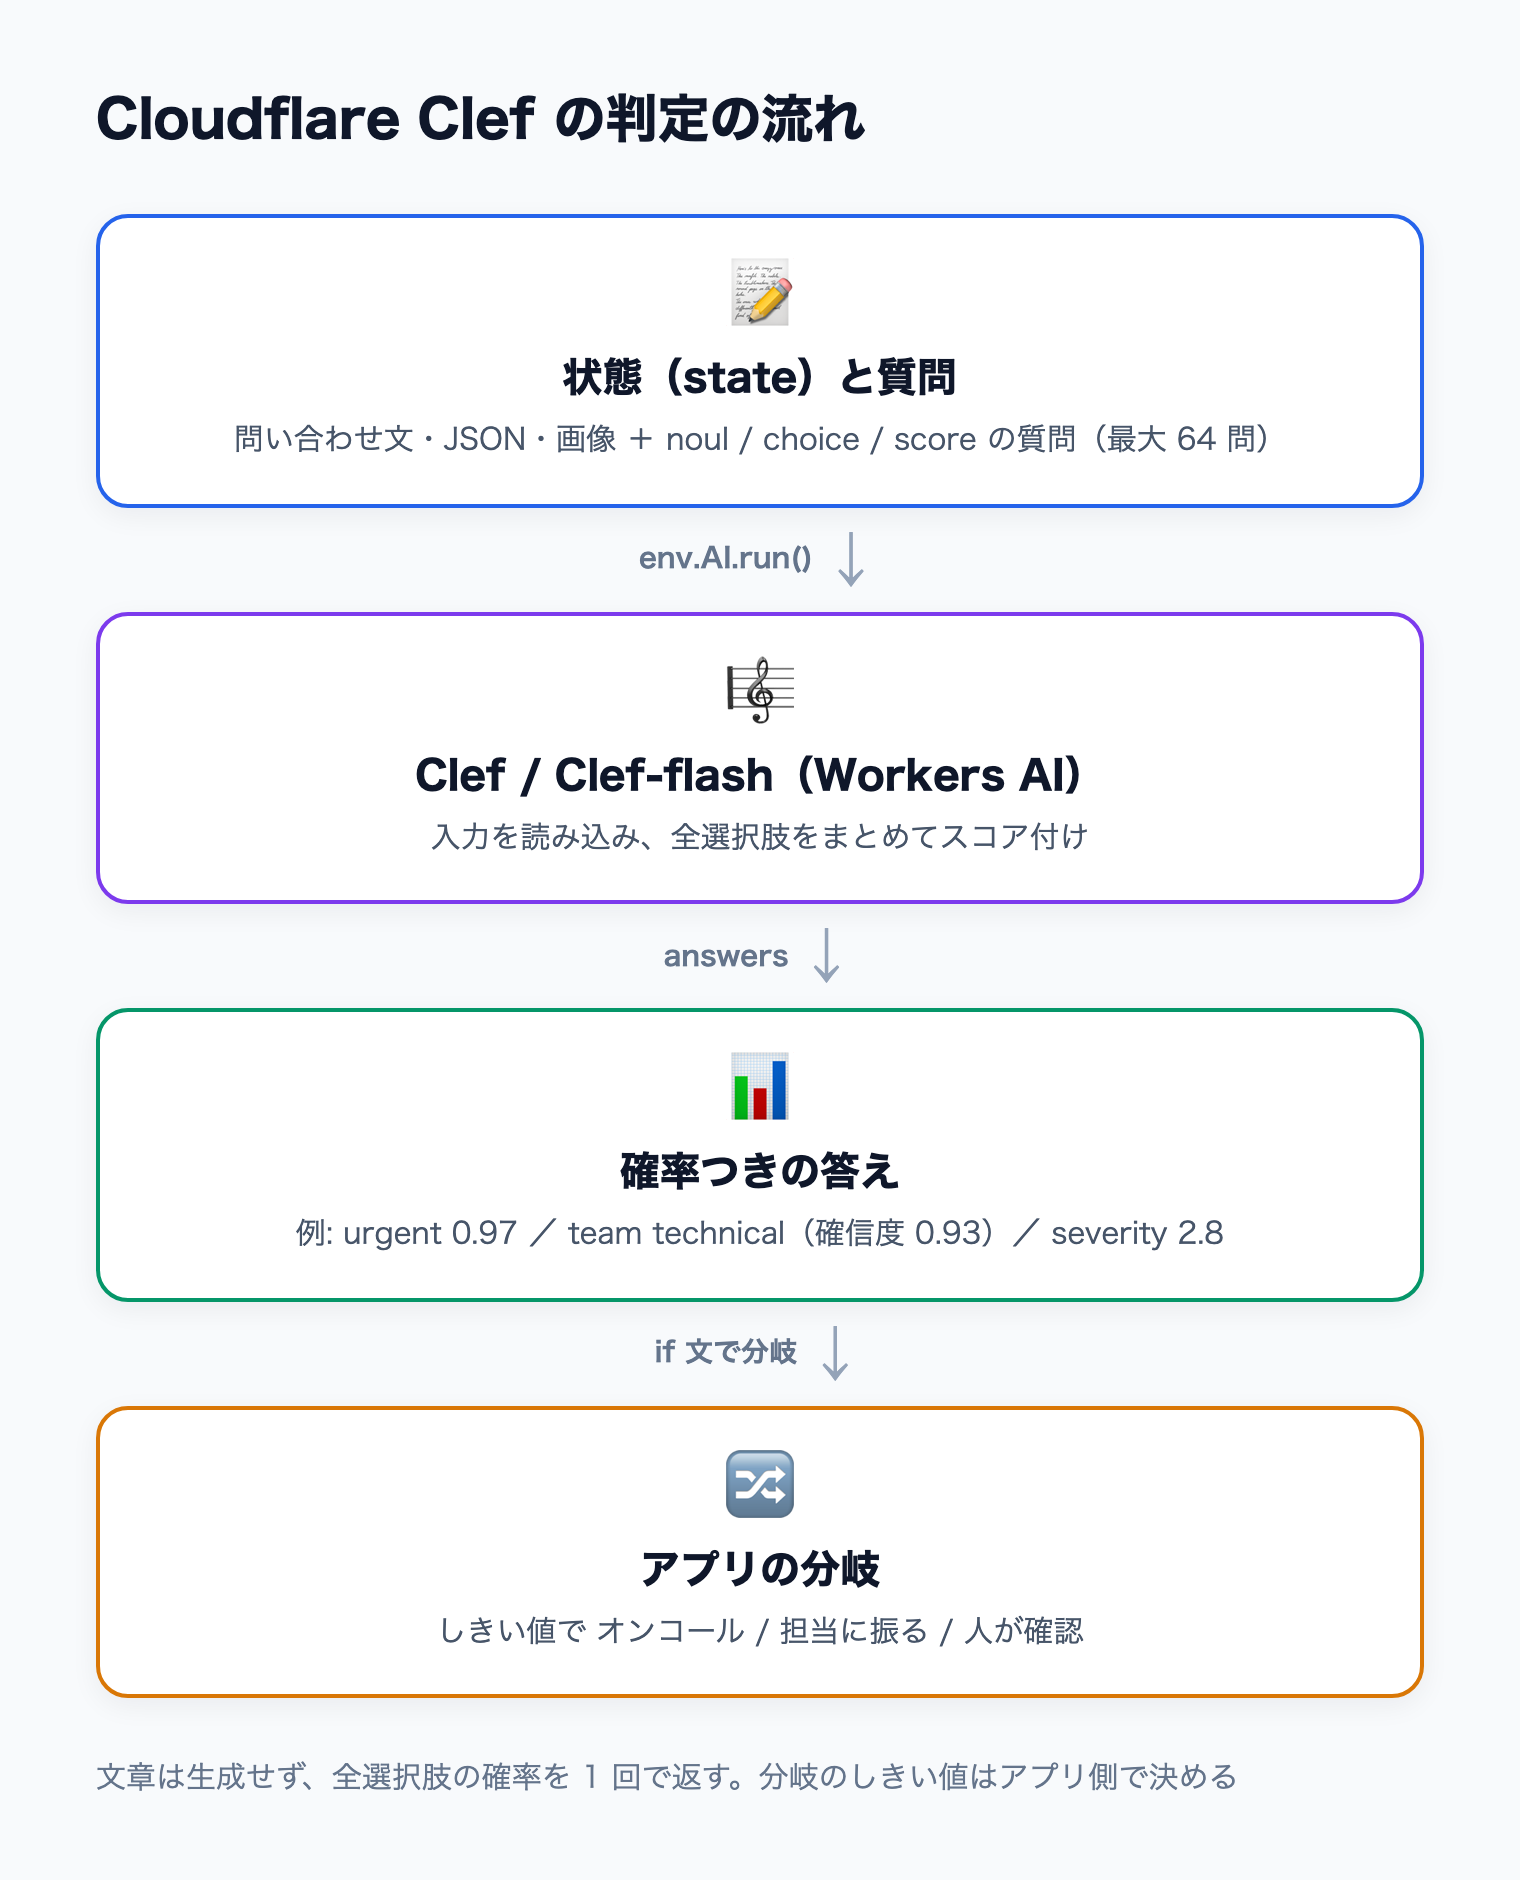
Clef は「この問い合わせは緊急か」「どのチームに回すか」「影響はどの段階か」といった判定を、決められた選択肢の中から確率つきで返すモデルです。公式ドキュメントは「状態と型つきの質問のスキーマを受け取り、すべての質問のすべての選択肢に確率を返す」モデルと説明しています2
状態と質問を Clef に渡すと、選択肢ごとの確率が返り、コード側のしきい値で処理を分ける流れ 図: 筆者作成(Cloudflare の公式ドキュメントをもとに作図)
できることは次の 3 種類の質問に限られます2 3
質問の型 何を聞くか 返ってくる値 noulはい/いいえ はいである確率(0〜1) choice自分で決めた選択肢(2〜255 個)から 1 つ 一番確率の高い選択肢、選択肢ごとの確率、確信度 score低い順に並べた段階(2〜10 段階)で評価 確率で重み付けした段階の値、段階ごとの確率、確信度
1 回のリクエストで最大 64 問まで聞けます2 state)は文字列でも JSON でもよく、画像を最大 4 枚まで添えられます2
うれしい点は 3 つあります。
出力の形が決まっている : 返り値は JSON スキーマどおりの数値と選択肢 ID だけです。LLM の出力のように「余計な前置きが付いてパースに失敗する」ことが起きません確率で分岐できる : 「緊急の確率が 0.8 以上ならオンコールを呼ぶ」「確信度が 0.6 未満なら人に回す」のように、しきい値をアプリ側で決められます速い : 公式の計測では、Clef-flash の応答時間の中央値は 38.8 ms です1
Hugging Face のモデルカードによると、Clef は Qwen3.8-27B、Clef-flash は Qwen3.5-9B を土台に後から学習したモデルです4 4 1
Clef が注目されるのは、2026 年 9 月に「判定モデル」という使い方が広まったばかりだからです。
2026-09-15 : TypeSafe AI が判定モデル「Jev」を早期アクセスで公開しました。構造化された判定だけを返し、入力は 100 万トークンあたり 0.042 ドル、出力は課金しないと説明しています5 2026-10-01 : Cloudflare が Clef と Clef-flash を公開しました。Jev と同じ API(System One API)に互換で、重みは Apache 2.0 で Hugging Face に置かれています1 6
Clef は Cloudflare の Birthday Week 2026 の発表の 1 つです。ほかの発表は「Cloudflare Birthday Week 2026 の発表まとめ 」にまとめています。
日本の検索の動きを見ると、Google トレンド(日本・過去 90 日、2026-10-05 取得)の相対値で、「Cloudflare Workers」は直近 4 週の平均が 2.0、その前の 8 週の平均が 0.8 と上向きです7
Google トレンドの相対値(日本・過去 90 日):「Cloudflare Workers」の直近 4 週と前 8 週の平均 データを表で見る Google トレンドの相対値(日本・過去 90 日):「Cloudflare Workers」の直近 4 週と前 8 週の平均 期間 Cloudflare Workers 前 8 週の平均 0.8 直近 4 週の平均 2
出典: Google トレンド(日本・過去 90 日、2026-10-05 取得)の相対値。基準語 GitHub Copilot と同じ回で取得 精度を優先するなら Clef、応答の速さを優先するなら Clef-flash を選びます。公式の changelog は、Clef を「最も精度の高い判定向け」、Clef-flash を「レイテンシが重要なホットパス向け」と書き分けています6
項目 Clef Clef-flash モデル ID @cf/@cf/パラメータ数 27B 9B 土台のモデル Qwen3.8-27B Qwen3.5-9B コンテキスト長 65,536 トークン 65,536 トークン 画像入力 対応 対応 料金(Workers AI) 入力 100 万トークンあたり 0.24 ドル 入力 100 万トークンあたり 0.09 ドル 応答時間の中央値 209.3 ms 38.8 ms 応答時間の p95 238.6 ms 122.4 ms
出典: モデル ID・コンテキスト長・料金はモデルページ2 3 4 1
公式ブログが Decision Index で計測した応答時間を並べると、差がはっきり分かります1
判定モデルの応答時間(Decision Index の 43 ベンチマーク、中央値と p95、ミリ秒) データを表で見る 判定モデルの応答時間(Decision Index の 43 ベンチマーク、中央値と p95、ミリ秒) モデル 中央値(ms) p95(ms) Clef 209.3 238.6 Clef-flash 38.8 122.4 Jev 524.1 536
出典: Cloudflare 公式ブログ「Introducing Clef」(2026-10-01)のレイテンシ表。Cloudflare による計測 精度はベンチマークによって勝ち負けが入れ替わります。たとえば意図分類の CLINC150+OOS(macro-F1)では Clef が 97.43、Clef-flash が 66.77 と大きく差が出ます1 1
ここでは、サポートの問い合わせを読んで「オンコールを呼ぶ」「担当チームに振る」「人が見る」の 3 つに振り分ける Worker を作ります。前提は Node.js 24、wrangler 4.147.0、TypeScript 5 系です。
wrangler.jsonc に ai のバインディングを書くと、コードから env.AI で Workers AI を呼べます。
{
"$schema" : "./node_modules/wrangler/config-schema.json" ,
"name" : "clef-ticket-router" ,
"main" : "src/index.ts" ,
"compatibility_date" : "2026-10-01" ,
"ai" : { "binding" : "AI" }
}
2026-10-05 時点の @cloudflare/(5.20261005.1)には、Clef 用の型がまだありません。そのため env.AI.run("@cf/ の戻り値は Record<string, unknown> になります。公式の入出力スキーマ(schema-input.json と schema-output.json)をもとに、自分で型を書いておくと扱いやすくなります2
export type NoulQuestion = {
type : "noul" ;
instructions : string ;
criteria ?: { true ?: string ; false ?: string };
};
export type ChoiceQuestion = {
type : "choice" ;
instructions : string ;
criteria : Record <string , string | null >;
};
export type ScoreQuestion = {
type : "score" ;
instructions : string ;
criteria : string [];
};
export type Question = NoulQuestion | ChoiceQuestion | ScoreQuestion ;
export type ClefRequest = {
model : "clef" | "clef-flash" ;
state : unknown ;
questions : Record <string , Question >;
images ?: string [];
};
export type NoulAnswer = { type : "noul" ; noul : number };
export type ChoiceAnswer = {
type : "choice" ;
choice : string ;
probabilities : Record <string , number >;
confidence : number ;
};
export type ScoreAnswer = {
type : "score" ;
score : number ;
legend : Record <string , unknown >;
probabilities : Record <string , number >;
confidence : number ;
};
export type ClefResponse = {
model : string ;
answers : Record <string , NoulAnswer | ChoiceAnswer | ScoreAnswer >;
usage : { input_tokens : number ; output_tokens : number };
};
const MODEL_ID = {
clef : "@cf/cloudflare/clef" ,
"clef-flash" : "@cf/cloudflare/clef-flash" ,
} as const ;
export async function runClef (ai : Ai , req : ClefRequest Promise <ClefResponse > {
const res = await ai.run (MODEL_ID [req.model ], req);
return res as unknown as ClefResponse ;
}
リクエストの model に "clef" か "clef-flash" を入れるのを忘れないでください。モデル ID とは別に、この項目が必須になっています2
質問は公式ドキュメントの例と同じ 3 問にしました2
import { runClef, type ChoiceAnswer , type NoulAnswer , type ScoreAnswer } from "./clef" ;
export type Route =
| { action : "page-oncall" ; team : string ; reason : string }
| { action : "assign" ; team : string ; reason : string }
| { action : "human-review" ; reason : string };
const URGENT_THRESHOLD = 0.8 ;
const MIN_CONFIDENCE = 0.6 ;
export async function triage (ai : Ai , message : string Promise <Route > {
const res = await runClef (ai, {
model : "clef-flash" ,
state : message,
questions : {
urgent : { type : "noul" , instructions : "Is this support request urgent?" },
team : {
type : "choice" ,
instructions : "Which team should handle this request?" ,
criteria : {
billing : "Payments, invoices, and refunds" ,
technical : "Outages, errors, and configuration" ,
sales : "Plans and upgrades" ,
},
},
severity : {
type : "score" ,
instructions : "How severe is the customer impact?" ,
criteria : ["No impact" , "Minor" , "Major" , "Critical" ],
},
},
});
const urgent = res.answers .urgent as NoulAnswer ;
const team = res.answers .team as ChoiceAnswer ;
const severity = res.answers .severity as ScoreAnswer ;
if (team.confidence < MIN_CONFIDENCE ) {
return { action : "human-review" , reason : `team confidence ${team.confidence.toFixed(2 )} ` };
}
if (urgent.noul >= URGENT_THRESHOLD && severity.score >= 2 ) {
return { action : "page-oncall" , team : team.choice , reason : `urgent ${urgent.noul.toFixed(2 )} , severity ${severity.score.toFixed(1 )} ` };
}
return { action : "assign" , team : team.choice , reason : `urgent ${urgent.noul.toFixed(2 )} ` };
}
score の score は「確率で重み付けした段階」なので、2.8 のように段階の間の値になることがあります2 severity.score >= 2 は「Major 以上」という意味です。
最後に、Worker の入口から triage を呼びます。
import { triage } from "./triage" ;
export interface Env {
AI : Ai ;
}
export default {
async fetch (request, env): Promise <Response > {
if (request.method !== "POST" ) return new Response ("POST only" , { status : 405 });
const { message } = await request.json <{ message : string }>();
const route = await triage (env.AI , message);
return Response .json (route);
},
} satisfies ExportedHandler <Env >;
分岐のロジックは、Clef の応答の形をまねた偽物の Ai を渡せば、Workers AI を呼ばずにテストできます。課金も発生しません。
import { describe, expect, it } from "vitest" ;
import { triage } from "./triage" ;
function fakeAi (answers : Record <string , unknown >Ai {
return {
run : async () => ({ model : "clef-flash" , answers, usage : { input_tokens : 120 , output_tokens : 0 } }),
} as unknown as Ai ;
}
describe ("triage" , () => {
it ("緊急かつ影響が大きければオンコールを呼ぶ" , async () => {
const ai = fakeAi ({
urgent : { type : "noul" , noul : 0.97 },
team : { type : "choice" , choice : "technical" , probabilities : { billing : 0.02 , technical : 0.96 , sales : 0.02 }, confidence : 0.93 },
severity : { type : "score" , score : 2.8 , legend : {}, probabilities : { "0" : 0 , "1" : 0.05 , "2" : 0.1 , "3" : 0.85 }, confidence : 0.8 },
});
expect (await triage (ai, "Checkout has been failing for every customer for the last hour." )).toMatchObject ({
action : "page-oncall" ,
team : "technical" ,
});
});
it ("担当チームの確信度が低ければ人に回す" , async () => {
const ai = fakeAi ({
urgent : { type : "noul" , noul : 0.3 },
team : { type : "choice" , choice : "sales" , probabilities : { billing : 0.4 , technical : 0.15 , sales : 0.45 }, confidence : 0.35 },
severity : { type : "score" , score : 0.6 , legend : {}, probabilities : { "0" : 0.5 , "1" : 0.4 , "2" : 0.1 , "3" : 0 }, confidence : 0.4 },
});
expect ((await triage (ai, "プランを変えたら請求額が変わった?" )).action ).toBe ("human-review" );
});
});
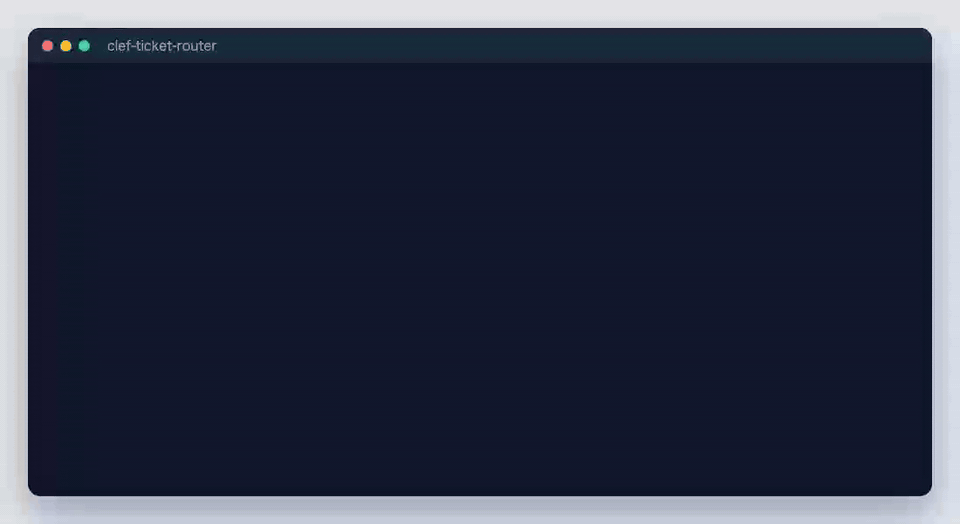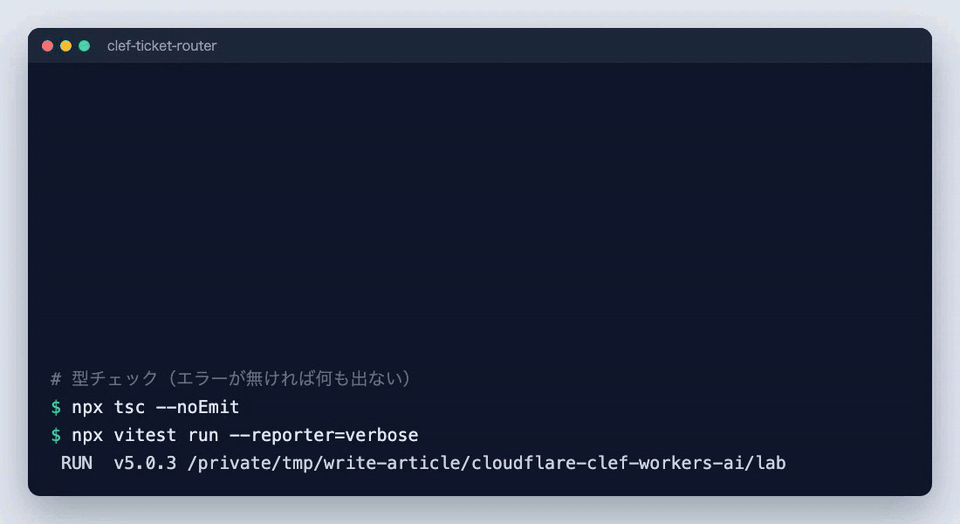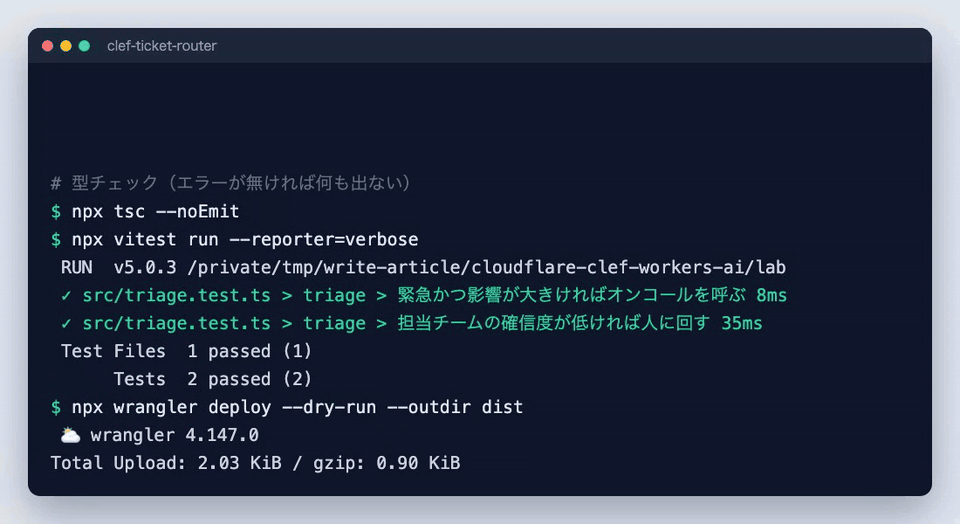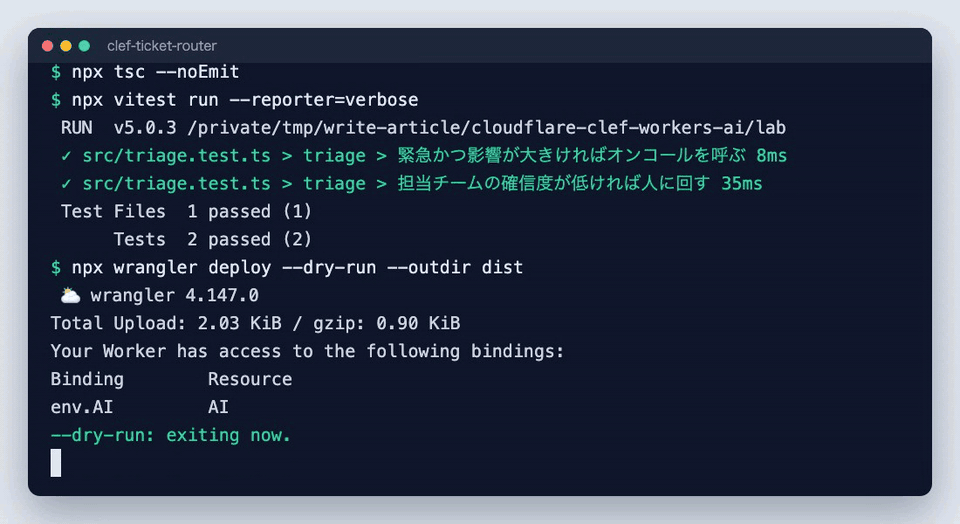
型チェック、テスト、デプロイの事前確認(--dry-run)を通した様子です。--dry-run は実際にはデプロイせず、バンドルとバインディングを確かめるだけです。
tsc の型チェック、vitest の 2 件のテスト、wrangler deploy --dry-run が通り、env.AI のバインディングが表示される様子 筆者の環境(macOS、Node.js 24、wrangler 4.147.0、vitest 5.0.3)で実行した出力
npx tsc --noEmit
npx vitest run --reporter=verbose
npx wrangler deploy --dry-run --outdir dist
本番の Clef を呼ぶには、ログイン後に npx wrangler deploy でデプロイします。筆者は課金を避けるため、実際のモデル呼び出しはしていません。
Workers 以外からは REST API で呼べます。公式ドキュメントの例は次のとおりです2
curl https://api.cloudflare.com/client/v4/accounts/$CLOUDFLARE_ACCOUNT_ID /ai/run/@cf/cloudflare/clef \
-X POST \
-H "Authorization: Bearer $CLOUDFLARE_AUTH_TOKEN " \
-d '{
"model": "clef",
"state": "Checkout has been failing for every customer for the last hour.",
"questions": {
"urgent": { "type": "noul", "instructions": "Is this support request urgent?" }
}
}'
Clef は「エージェントが次に何をするかを決める分かれ道」に置くと効きます。Cloudflare は、Clef で判定してから Workers AI の LLM に実際の作業を任せる組み合わせを勧めています1
問い合わせの振り分け : この記事のコードのように、緊急度・担当・深刻度を 1 回で判定し、確信度が低いものだけ人に回しますドメインの分類 : Cloudflare の脅威インテリジェンスチームは、Browser Run でサイトを取得して Clef に分類させています。取得・描画・分類で 2.2 秒、同じ処理を gpt-oss-120b で行うと 4.7 秒かかったと公式ブログは書いています1 画像を含む判定 : Clef は画像を読めます。Jev は 2026-10-01 時点で文章の分類のみと、公式ブログは説明しています1 LLM の出力のチェック : 生成した回答に個人情報が含まれるか、方針に反していないかを noul で判定し、しきい値を超えたら止めます
エージェント全体の作り方は「Cloudflare Agents SDK で AI エージェントを作る 」で扱っています。Clef の判定はツールの 1 つとして組み込めます。
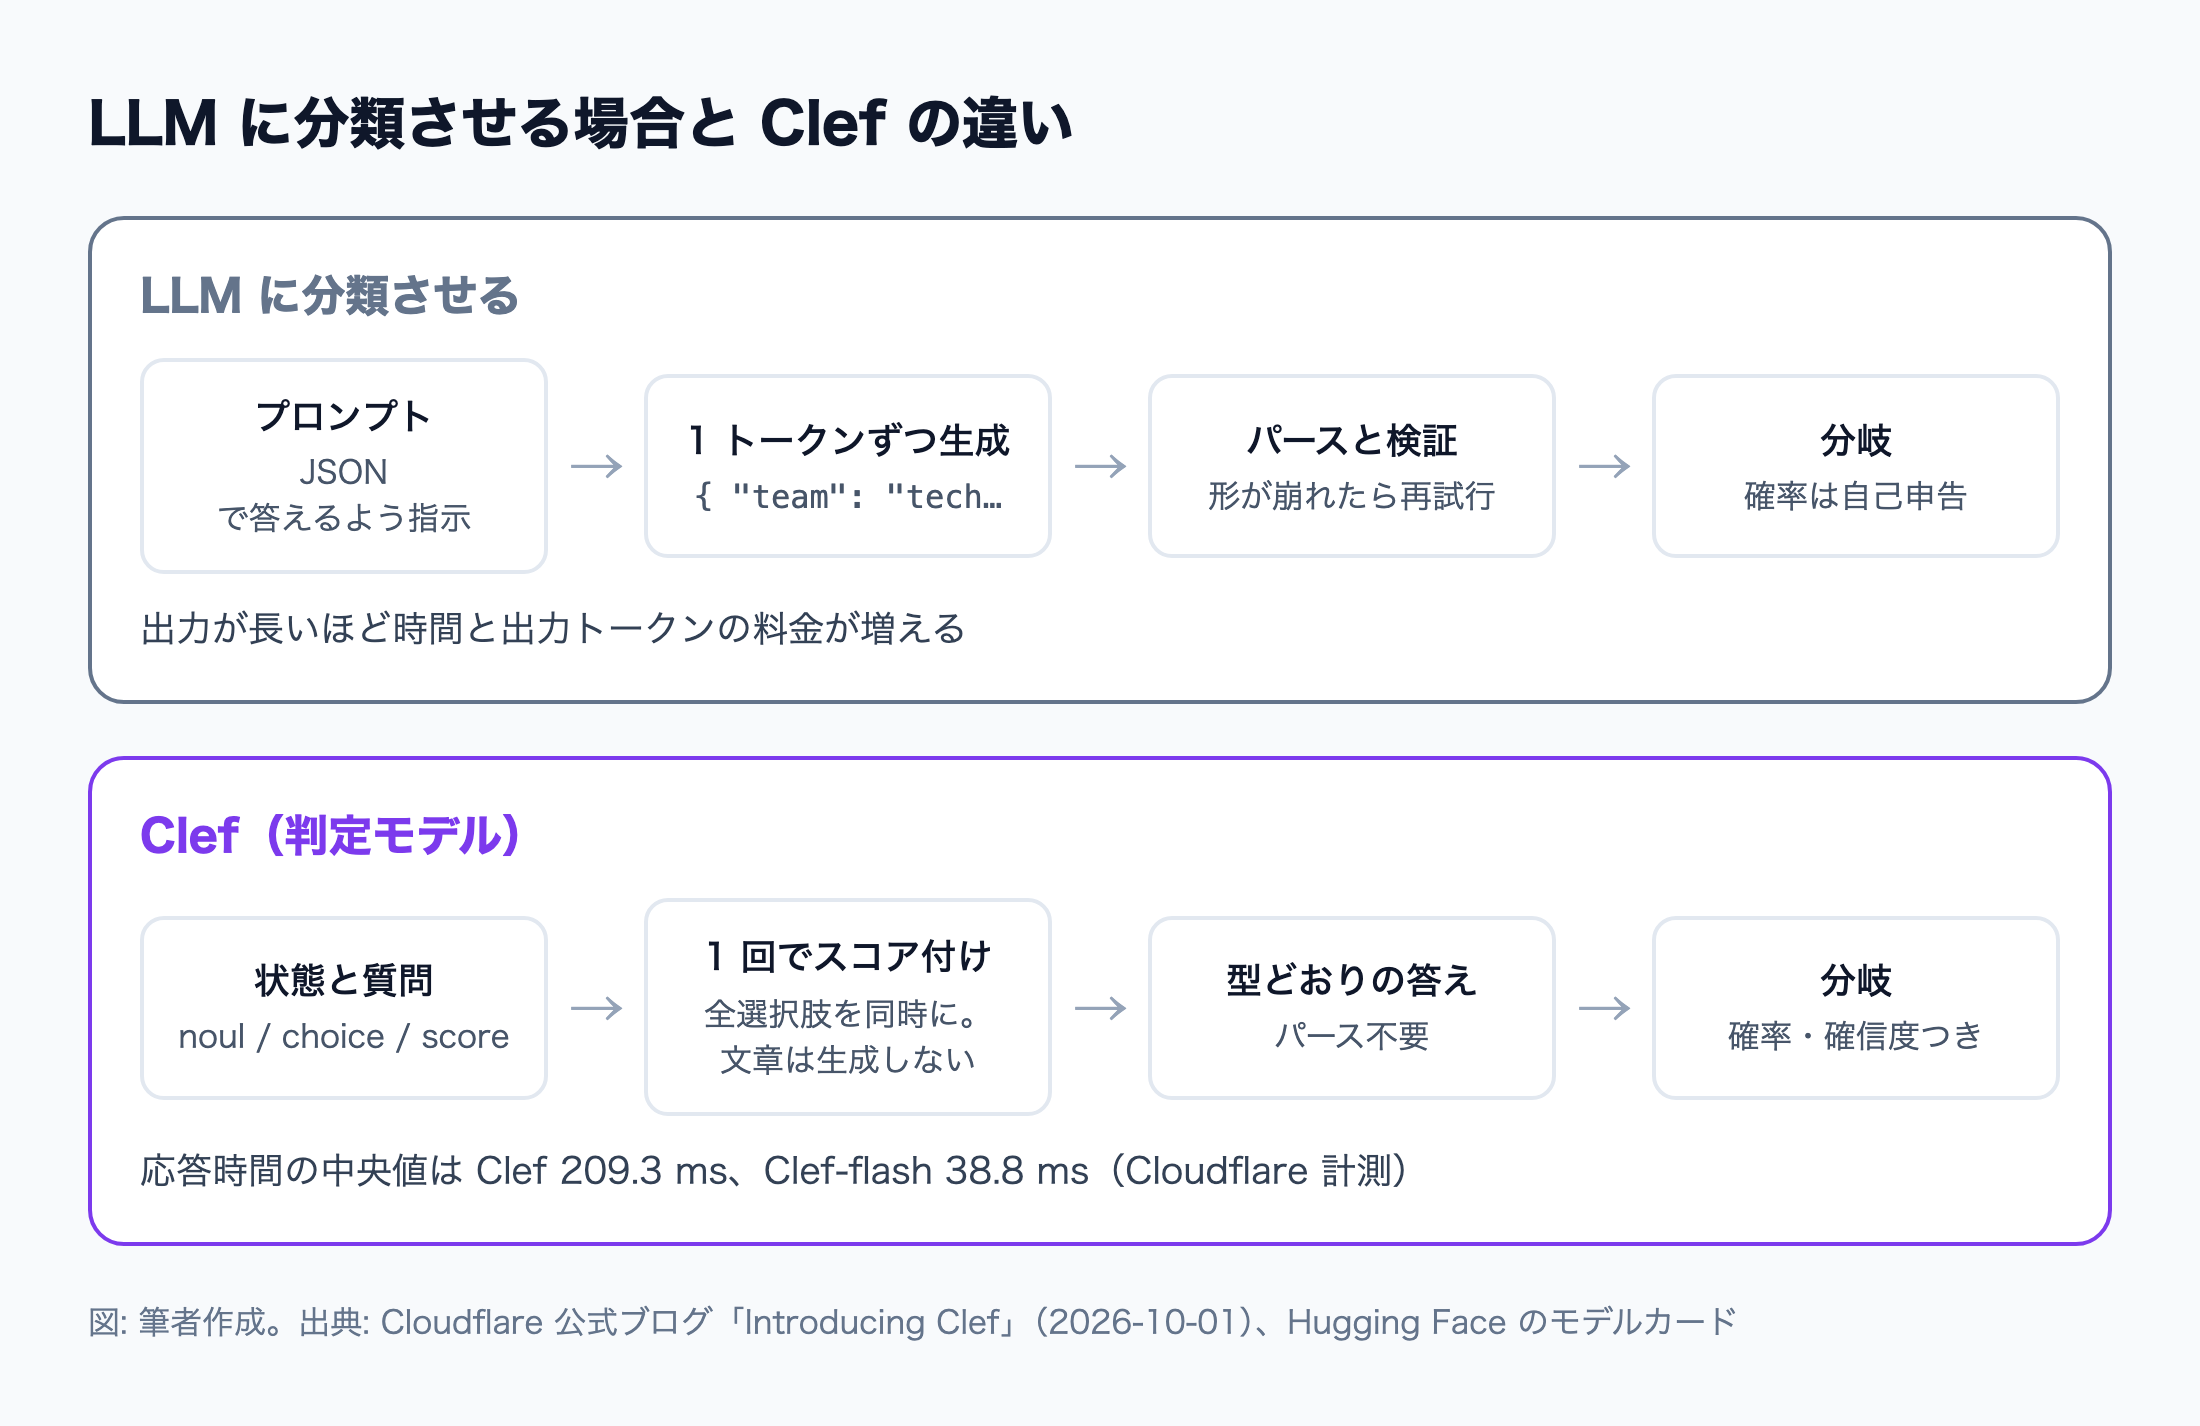
決まった選択肢から選ぶだけなら Clef、理由の説明や文章の生成も要るなら LLM、と使い分けます。
LLM は文章を 1 トークンずつ生成してから JSON をパースするのに対し、Clef は全選択肢の確率を 1 回で返す違いの比較 図: 筆者作成(Cloudflare 公式ブログとモデルカードをもとに作図)
観点 LLM に分類させる Clef 出力 文字列。JSON を指示してもパースと検証が要る スキーマどおりの選択肢 ID と確率 生成の仕方 1 トークンずつ順に生成 全選択肢を 1 回の計算でスコア付け1 確率 自己申告させても安定しない 選択肢ごとの確率と確信度が必ず付く2 向いている仕事 説明・要約・コード生成・ツール呼び出し 分類・はい/いいえ・段階評価・振り分け できないこと ― 文章の生成、理由の説明
料金は、Clef の単価が入力トークンにだけ設定されている点が LLM と違います2 3 8 8
Workers AI の入力単価(100 万トークンあたり、ドル):Clef と主な LLM データを表で見る Workers AI の入力単価(100 万トークンあたり、ドル):Clef と主な LLM モデル 入力の単価(ドル) clef-flash 0.09 clef 0.24 gpt-oss-120b 0.35 qwen3.8-27b 0.45
出典: Cloudflare Docs の Clef / Clef-flash モデルページと Workers AI 料金表(2026-10-05 参照)。LLM の出力単価は gpt-oss-120b 0.75 ドル、qwen3.8-27b 3.20 ドル qwen3.8-27b は Clef の土台と同じ系列のモデルです4
1 回の判定にかかる費用は、入力トークン数から計算できます。たとえば入力が 1,000 トークンなら、Clef は 0.00024 ドル、Clef-flash は 0.00009 ドルです(単価 × トークン数の計算)。実際のトークン数は応答の usage.input_tokens で確かめられます2
Workers AI の費用を上限つきで管理したい場合は「Workers AI と AI Gateway で LLM の費用を管理する 」の手順が Clef にもそのまま使えます。
Clef は Jev と同じ API に互換なので、Jev を使っているコードはエンドポイントとモデル名を変えるだけで Clef に切り替えられます6 4
違いは公式ブログに次のように書かれています1
Clef は画像を読める。Jev は文章の分類のみ
コンテキスト長は Clef が 64K、Jev が 32K
TypeSafe の業務ワークフロー評価 4 種のうち、請求書処理・カスタマーサービス・セキュリティインシデントの 3 種で Clef が Jev を上回った
TypeSafe 側は、Jev の入力単価を 100 万トークンあたり 0.042 ドル、出力は無料と公表しています5
Cloudflare は Clef を自社の用途に合わせて学習し直す、強化学習(RL)のファインチューニングも始めました1 1
AI Gateway で実際のリクエストを集めてデータセットにする
Workers AI で元の Clef に試行させる
Containers を強化学習の採点用サンドボックスにする
新しい「Trainer」で重みを更新する
学習したモデルを Workers AI に載せ直す
2026-10-05 時点では、デザインパートナーとして申し込む形です6
model を入れ忘れるmodel("clef" か "clef-flash")は必須です。モデル ID と合わせて指定します2 画像の URL を渡してしまう : images は data URL か base64 だけを受け付け、外部 URL は使えません。1 枚 4 MiB・1,600 万画素まで、合計 8 MiB、リクエスト全体で 13 MiB までです2 質問や選択肢が多すぎる : 質問は 1〜64 問、choice の選択肢は 2〜255 個、score の段階は 2〜10 段階です2 長い入力が黙って切られる : 長い文字列の state は、モデルのトークン上限に収まるよう切り詰められます2 型が無い : 上で書いたとおり、2026-10-05 時点の @cloudflare/ には Clef の型がありません。公式のスキーマから自分で定義します日本語での精度 : 公開されているベンチマークは英語のデータが中心で、日本語での評価は公式には載っていません。日本語の問い合わせに使う前に、実際のデータで正解率を測ってからしきい値を決めてください料金表に行が無い : Workers AI の料金表(2026-10-05 時点)には Clef の行がまだありません。単価はモデルページの記載(入力 100 万トークンあたり 0.24 ドル / 0.09 ドル)で確認しました2 3 8
Cloudflare Clef は、文章を生成せず、noul・choice・score の 3 種類の質問に確率で答える判定モデルです
Workers からは env.AI.run("@cf/ で呼べます。型はまだ無いので公式スキーマから定義します
精度重視なら Clef(27B、入力 100 万トークンあたり 0.24 ドル)、速さ重視なら Clef-flash(9B、0.09 ドル、中央値 38.8 ms)です
決まった選択肢から選ぶだけなら Clef、説明や生成も要るなら LLM と使い分け、確信度が低い判定は人に回す設計にします
次にやること: 自分の業務の問い合わせやログを 100 件ほど用意し、Clef と Clef-flash の両方で正解率と確信度の分布を測って、しきい値を決めましょう
Workers AI には 1 日 10,000 Neurons の無料枠があり、Workers の Free プランでも使えます8 2 3
できません。Clef が返すのは、決められた選択肢ごとの確率と、一番確率の高い選択肢、確信度だけです2 4
まず Clef-flash で試し、正解率が足りない質問だけ Clef に切り替えるのが手軽です。Clef-flash は応答時間の中央値が 38.8 ms と速く、単価も低いからです1 3
できます。重みは Apache 2.0 ライセンスで Hugging Face に公開されています1 4 torch と transformers から読み込む手順が載っています4
エンドポイントとモデル名を変えます。Clef は Jev と同じ System One API に互換です6 4 images は Clef 独自の拡張です2